计算机组成原理
概述
大部分计算机遵循冯诺依曼架构。核心是存储程序。把程序和数据先存进存储器。计算机启动后自动一条一条取出指令并运行。不需要人工插线干预。冯诺依曼规定计算机有五个架构组成。
分别是控制器 运算器 存储器 输入设备 输出设备。
指令和数据都是二进制表示。早起的冯诺依曼架构以运算器为核心,输入输出都要经过运算器。现代计算机改为以存储器为中心。让IO设备直接和内存交换数据,运算器可以腾出手来做的别的事情。
运算器和控制器加在一起,就是中央处理器CPU。CPU加上主存储器叫做主机。输入输出设备和辅助存储器,统称为外部设备。指令和数据放在同一个存储器里,CPU靠时间阶段区分它们。取址阶段取出的是指令,执行阶段取出的是数据。
主存储器的内部,每个单元有一个地址。
CPU访问主存要经过俩个地址,MAR存要访问的,MDR存放读出的、或者要写入的数据。
MAR(Memory Address Register,存储器地址寄存器)
- 放要访问的主存单元的地址
- CPU 把地址送入 MAR,再通过地址总线送到主存
- 它的位数决定了 CPU 能寻址的最大主存空间(如 MAR 20 位 → 最大 1M 个单元)
MDR(Memory Data Register,存储器数据寄存器)
- 存放从主存读出的数据,或要写入主存的数据
- 通过数据总线与主存交换信息
- 它的位数通常等于存储字长
读取流程
- CPU 将地址送入 MAR
- MAR 内容经地址总线送到主存,主存译码选中单元
- 该单元内容经数据总线送入 MDR
- CPU 从 MDR 取走数据
写操作流程
- CPU 将地址送入 MAR,将数据送入 MDR
- 地址经地址总线送到主存,数据经数据总线送到主存
- 主存将 MDR 中的数据写入 MAR 指定的单元
MAR的位数决定能访问多少个单元,比如32位就能寻址2的32次方个单元。
MDR的位数等于存储字长。也就是一个存储单元有多少个字节。
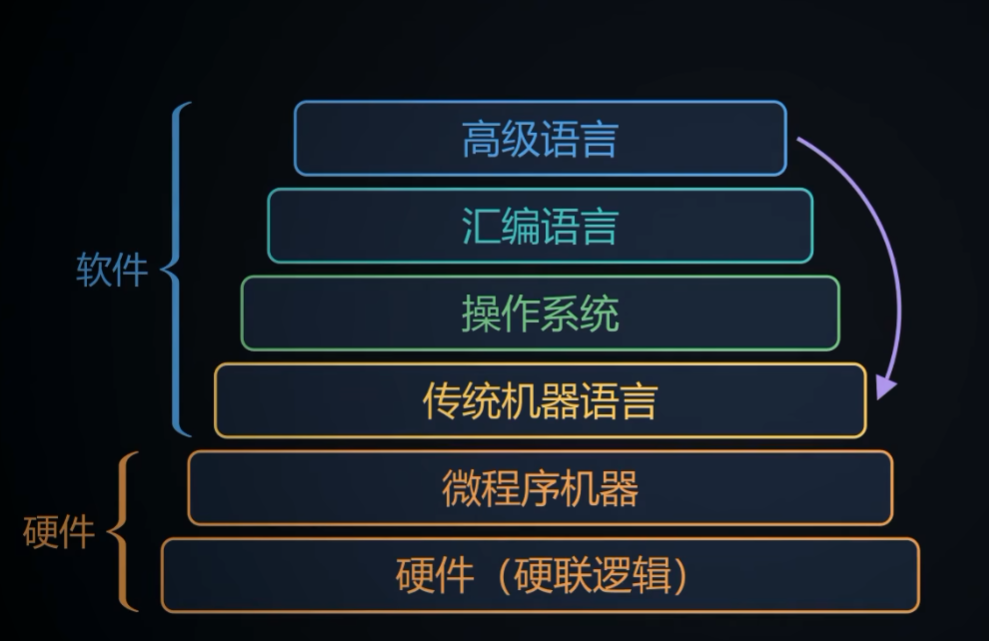
性能
衡量计算机的性能线看字长。机器字长是CPU一次能处理二进制位数。通常等于通用寄存器和运算器的位数。
比如64位CPU,字长越长精度越高。CPU的一切都是时钟驱动的,时钟周期是CPU最小的时间单位,主频是它的倒数。比如2GHZ时钟周期就是0.5纳秒。执行一条指令需要若干个时钟周期。平均每条指令需要的时钟周期数叫CPI(Cycles Per Instruction)。
这里总时钟周期数(total cycles)只这段程序期间CPU实际走过的时钟周期数。
CPI = 总时钟周期数 / 指令数
CPI越大,说明每条指令平均花费的时间越长,性能越差。理想流水线(无停顿)下CPI接近1,超标量处理器CPI可以小于1。、
IPC(Instructions Per Instruction Cycle / Instructions Per Cycle)
IPC= 指令总数 / 总时钟周期数 = 1/CPI
IPC越大,说明每个周期能完成的指令越多,性能越好,现代超标量处理器IPC可以大于1。
CPI是从指令角度看需要几个周期,IPC是从周期角度看一个周期能完成几个指令。
CPU执行时间=指令条数 x CPI / 主频 = 指令条数 x CPI x 时钟周期
超标量 superscalar是CPU在一个时钟周期内能完成同时发射并执行多条指令的魏家沟设计。它是相对于标量而言的。
传统标量流水线每个周期只取一条、发射一条指令,CPI理想为1。超标量通过复制多套执行资源,让一个周期内有多条指令并行推进。
任何CPI内部本来就有海量逻辑门同时翻转,这是电路层面的并行,标量CPU也一样。真正的问题是,标量CPI一个周期只发射一条指令,所以即使有俩条无关的指令,它也只能排队一条一条走流水线。
超标量是流水线批量执行+每拍多宽度。
多宽度是CPU流水线的每一级能同时执行处理多少指令。它描述的是流水线的横向宽度,而不是纵向深度。
- 标量(单宽度):传送带每次只过 1 条指令。取指取 1 条,译码译 1 条,发射发 1 条,执行算 1 条。
- 多宽度(超标量):传送带每次能并排过 N 条指令。取指一次取 4 条,译码一次译 4 条,发射一次发 4 条……这个 N 就是宽度。
每一拍都在处理“一批”(宽度条),而且不需要攒够一批才开始——上一批还在跑,下一拍照样取。
让程序变得更快有三条路。
减少指令条数,降低CPI,提高IPC。三者往往互相牵制。
作为芯片设计者:为了提升主频把指令拆成更细的操作(加深流水线级数),虽然能让时钟频率跑的更高,但每条指令平均需要的时钟周期数CPI可能会增加,最终性能未必提升。
CPU 执行时间 ≈ 指令数 × CPI × 时钟周期。提高主频(缩短时钟周期)能缩短执行时间,但 CPI 变大会抵消这个收益。
为了让流水线满负荷运转,取值单元必须每个周期都有指令可取。但遇到分支条件时,下一条指令地址取决于分支结果,而分支结果往往要到流水线后端才能算出。
如果傻等结果,流水线前段全部停顿,CPI上升;分支越密,停顿越多。
分支预测就是用猜测替代等待,猜对了,流水线照常流动,猜错了,付出flush代价。
很知名的,Why is processing a sorted array faster than processing an unsorted array? 当然这只适用于有条件分支的代码。
package main

import (
    "fmt"
    "math/rand"
    "time"
)

// 核心处理逻辑:带条件分支,正是分支预测起作用的场景
func process(data []int) int {
    sum := 0
    for _, v := range data {
        if v >= 128 { // 关键的条件分支
            sum += v
        }
    }
    return sum
}

func main() {
    const N = 1 << 16 // 65536 个元素,足够体现差异
    r := rand.New(rand.NewSource(42))

    // 生成 0~255 的随机数据
    base := make([]int, N)
    for i := range base {
        base[i] = r.Intn(256)
    }

    // 有序版本:复制一份后排序
    sorted := make([]int, N)
    copy(sorted, base)
    // 简单插入排序太慢,这里用标准库;为演示清晰,手动写个快排也行
    sortInts(sorted)

    // 测量有序
    t1 := time.Now()
    s1 := process(sorted)
    d1 := time.Since(t1)

    // 测量无序
    t2 := time.Now()
    s2 := process(base)
    d2 := time.Since(t2)

    fmt.Printf("有序: sum=%d, 耗时=%v\n", s1, d1)
    fmt.Printf("无序: sum=%d, 耗时=%v\n", s2, d2)
    fmt.Printf("无序/有序 = %.2f 倍\n", float64(d2)/float64(d1))
}
流水线的设计初衷是让取指、译码、执行等步骤重叠进行,理想情况下每个时钟周期都能完成一条指令。但遇到分支指令时,麻烦就来了:CPU 在取指阶段之后、真正算出分支结果之前,并不知道下一条该取哪里的指令。
如果没有分支预测,流水线就必须停顿,等分支结果算出来再继续取指,这会造成流水线“气泡”,浪费周期。分支预测的作用就是在结果出来之前,先猜一个方向,让流水线继续满负荷运转。猜对了,流水线毫无停顿;猜错了,就要把已经取进来但猜错路径上的指令冲刷掉(flush),重新从正确地址取指,产生惩罚。流水线越深,猜错的代价通常越大。
MIPS是每百万跳指令 Million Instructions Per Second 的缩写。用来衡量cpu每秒能执行多少百万条机器指令。
MIPS在同一款处理器,指令集,程序的前提下,MIPS数值越高,通常意味着执行速度更快,大致反应了CPI的指令吞吐能力。
但是MIPS是一个粗略的、特定调价下的参考值。不同指令集下一条指令的含金量不同。CISC架构的一条指令可能做了更多的事情,0而RISC架构需要多条指令才能完成同样的工作。因此直接对比MIPS数值没有意义。
需要看实际运行目标程序所需的时间。
其他指标还有,吞吐量,响应时间,FLOPS(每秒浮点运算次数)。
CPU字长,指令字长,存储字长三者是不同概念,但通常是8的整数倍。
进制和编码
计算机中所有数据最终都是二进制。为了表示有符号数(正负),人们设计了三种编码方式。以 8 位为例,最高位是符号位(0 表示正,1 表示负),其余位是数值位。
计算机用高电平和低电平表示1和0,简单可靠,还能用位运算模拟加减法。
带符号的整数有1位来表示符号位。0代表正1代表负。正数的原码,反码,补码完全一样。
| 编码 | +5 | -5 | 零的个数 | 主要用途 |
|---|---|---|---|---|
| 原码 | 0000 0101 | 1000 0101 | 2 | 教学、理解 |
| 反码 | 0000 0101 | 1111 1010 | 2 | 历史过渡 |
| 补码 | 0000 0101 | 1111 1011 | 1 | 整数存储与运算(主流) |
| 移码 | 1000 0101 | 0111 1011 | 1 | 浮点数阶码、比较大小 |
计算机普遍用补码,因为可以把减法变成加法,符号位也能直接参与运算。
有两个零(+0 和 -0),逻辑上冗余。
加减法不能统一:做加法时若符号不同,硬件必须先比较绝对值大小、再决定做减法并确定符号,电路复杂。
减法需要单独的减法器,或者把减法转成“加负数”时还要特殊处理符号。
补码统一加减法,简化ALU设计。这是补码最核心的重要。
a - b = a + (-b) = a + [b]补的负数形式硬件只需一个加法器,减法通过取补再加实现。CPU的ALU不需要单独的减法电路、不需要比较绝对值、不需要处理符号位特判。直接减少了晶体管数量降低延迟。
对 n 位二进制:
- 正数:补码 = 原码(符号位0,数值位不变)。
- 负数:补码 = 原码的符号位不变,数值位按位取反,再末位加1;等价地,反码 + 1。
例如 8 位下 -5:
原码:1000 0101
反码:1111 1010   (符号位不变,数值位取反)
补码:1111 1011   (反码+1)
ZF、SF、OF、CF、PF、AF 是状态标志位。它们本质上是 CPU 内部一个特殊寄存器(EFLAGS/RFLAGS)中的独立比特位,用来“记录”上一条算术或逻辑指令执行后的结果特征。它们本身不存储数据,而是作为条件判断的依据,让程序(通过条件跳转指令)能够根据不同的结果走向不同的分支,从而实现 if-else、循环等逻辑。
移位运算,向左移位右边补0,右移左边补0.
位数扩展
通常发生在数据从较小的位宽(如 8 位)搬运到较大的位宽(如 32 位寄存器)时,为了保持数值不变,需要填充高位。根据数据类型不同,有两种主要方式:
通常发生在数据从较小的位宽(如 8 位)搬运到较大的位宽(如 32 位寄存器)时,为了保持数值不变,需要填充高位。根据数据类型不同,有两种主要方式:
零扩展:高位直接填充 0。适用于无符号数,因为无符号数的高位本来就是 0,填充后数值不变。
符号扩展:将高位全部填充为原数据的最高位(符号位)。适用于有符号数(补码)。例如,一个 8 位的负数(最高位为 1)扩展到 32 位时,高 24 位全部补 1,这样其负数值才能保持不变。
C语言中,int强制转换为short高位直接阶段,数值可能改变。把short转换成int,做符号扩展,数值不变。
浮点数
定点数太小表示不了太大或者太小的数据。所以有了浮点数,类似科学计数法,一个数等于尾数乘以2的接码次方。
接码是整数,确定了数的表示范围。位数是小数,决定了数的精度。为了让精度最高,要求尾数的最高有效位是1,这叫规格化。
现在的规范是IEEE 754标准,单独浮点float共32位。1位符号s,8位解码E,23位尾数M。
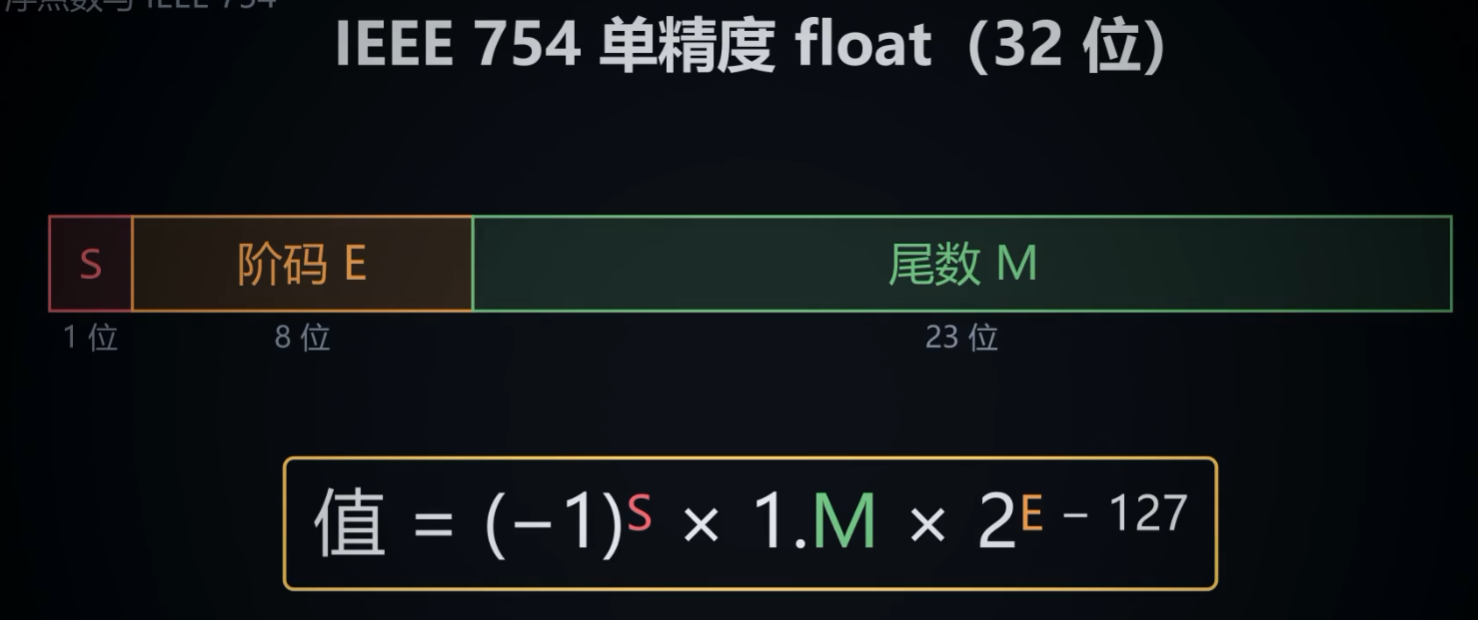
尾数字段,只有23位,但实际有效精度是24位,多出来的一位就是隐藏位。接码用移码存储。
双精度,double
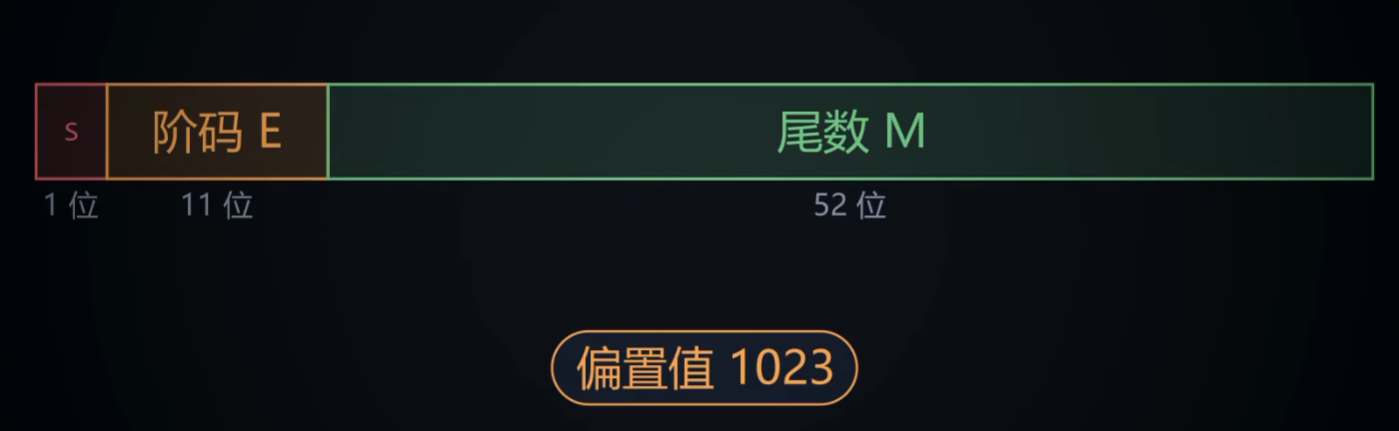
float最大正数大概是3.4 x 10^38
int有31位有效数字,float只有24位,因此int转float可能丢失精度。float转double则不会。
此外0.1这样的十进制小数无法用二进制精确表示。
大端小端
一个多字节的数,在内存里怎么排列。
比如4字节的16进制0x12345678.
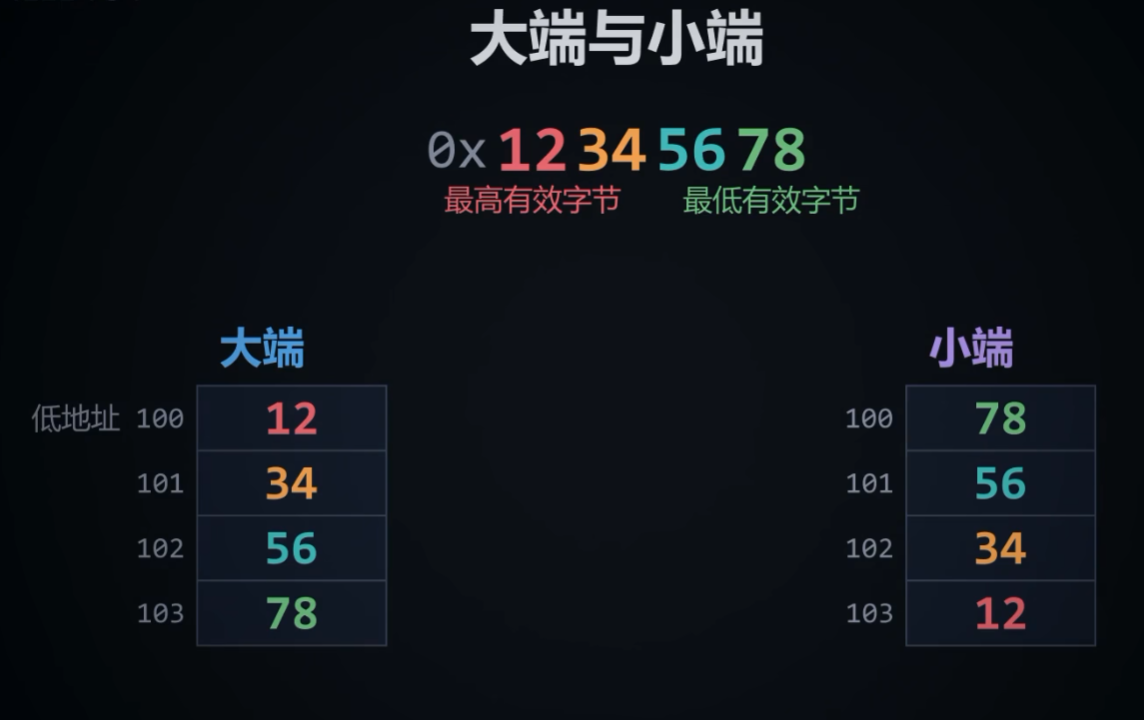
x86是小端,arm默认是是小端,但是可以切换为双端。
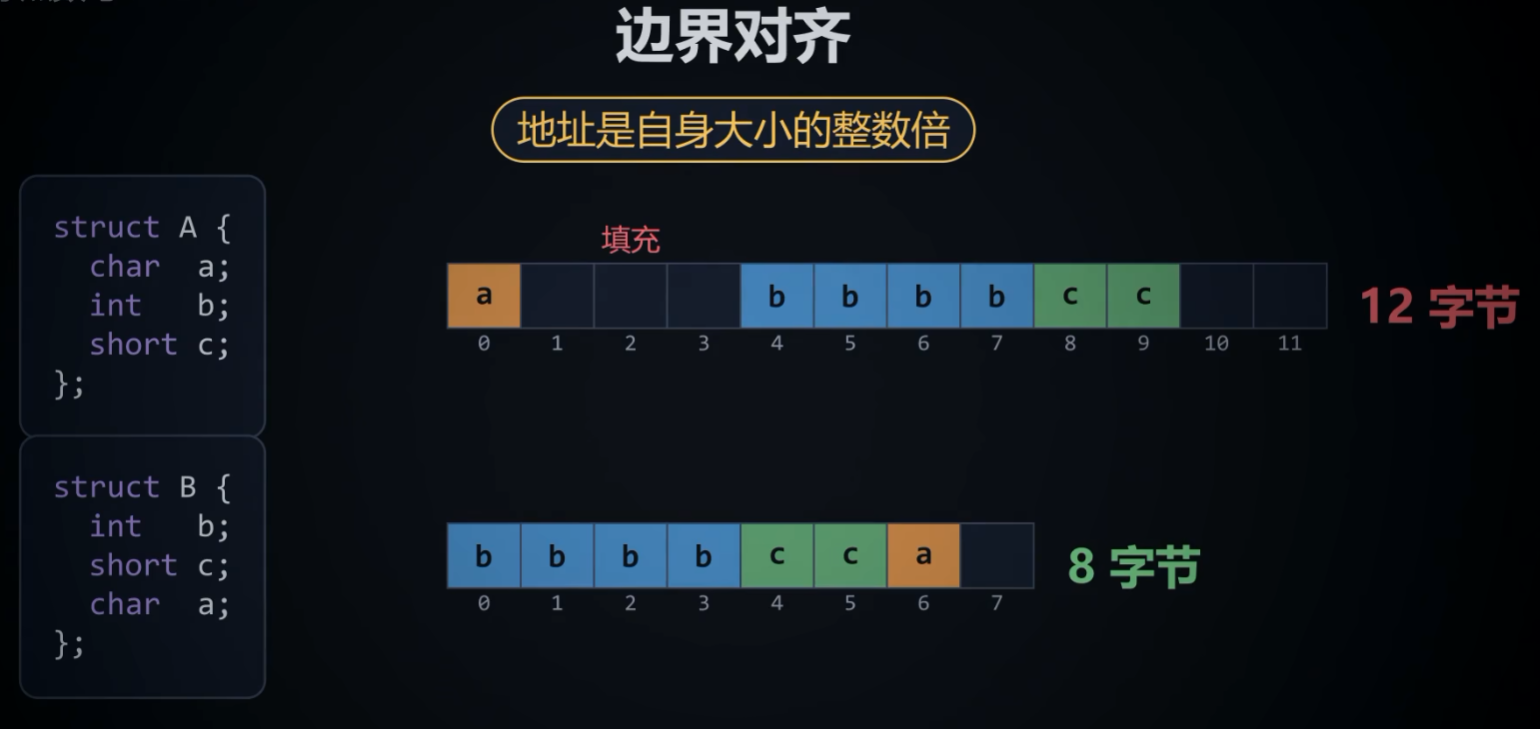
边界对齐,要求地址是自身大小的整数倍。
存储器的层次结构
CPU存储分别是寄存器,cache,主存,磁盘,磁带光盘。
单张光盘的容量确实远小于机械硬盘,可能更便宜。小容量蓝光盘在某些渠道下可能更低,但这是拿“很多张盘”换来的低价。算上刻录机、时间、管理麻烦,以及大容量蓝光盘本身并不便宜,机械硬盘通常更实际。尤其大容量机械硬盘每 TB 单价可以压得很低,而 100G 蓝光盘每 TB 成本反而可能更高。
存储器有多重分类方式:按存取方式分
- RAM,随机存取,任何单元访问时间相同(某种意义上,固态硬盘也是RAM,因为是随机存取的存储设备。D表示动态,决定是否易失)
- ROM,只读存储器,也是随机存取
- SAM:顺序存取,比如磁带
- DAM:直接存取,例如磁盘,光盘。
按断电后信息丢失,可以划分为易失性存储,和非易失性存储。
| SRAM(静态) | DRAM(动态) | |
|---|---|---|
| 存储原理 | 双稳态触发器 | 电容电荷 |
| 刷新 | 不需要 | 需要 |
| 速度 | 快 | 慢 |
| 集成度 | 低 | 高 |
| 功耗 / 价格 | 大 / 贵 | 小 / 便宜 |
| 用途 | Cache | 主存 |
SRAM主要用于CPU缓存。
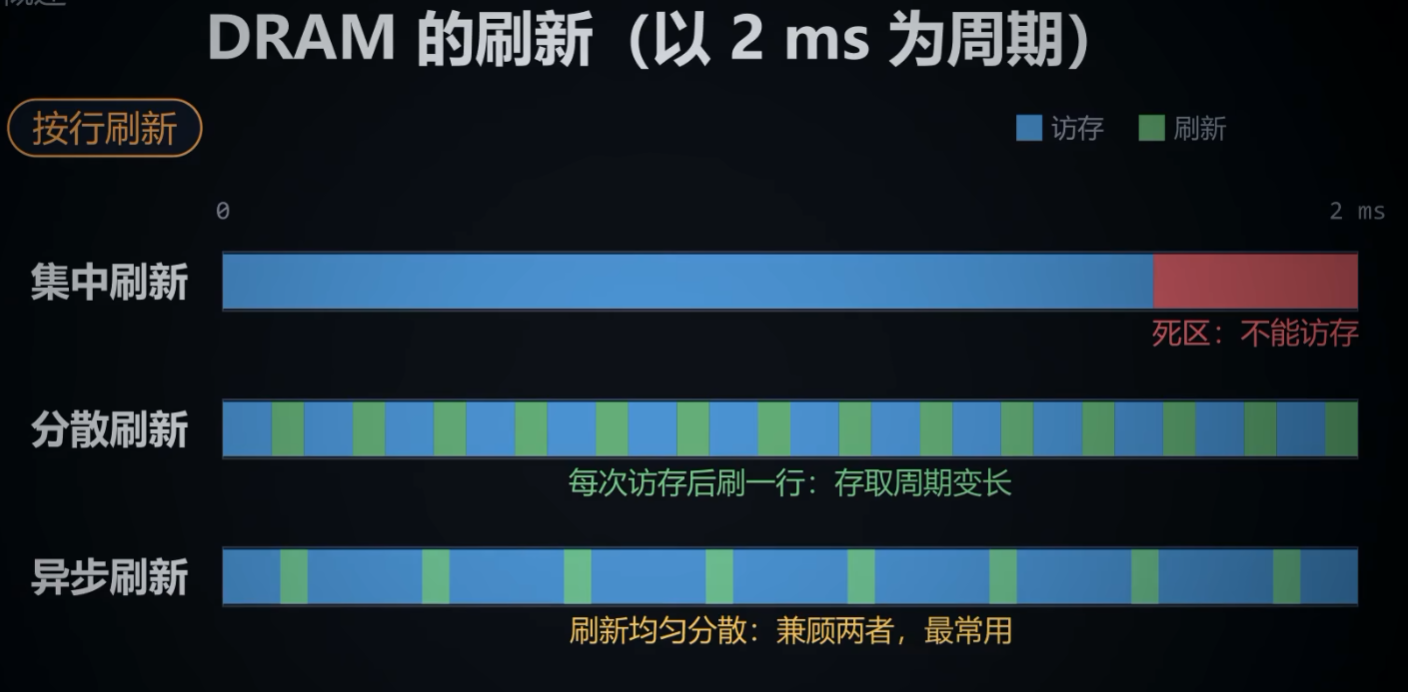
DRAM刷新是一行一行进行的,一般要求在2ms内把所有行刷新一遍。
DRAM需要刷新,根本原因在于它用电容存储数据,而电容会漏电。若不定期把数据读出来重新写回去,电荷流失到一定程度,数据就会丢失。
DRAM 的每一个存储单元(1 bit)由一个晶体管和一个电容组成。电容里存有电荷代表“1”,没电荷代表“0”。但现实中电容并非完美,电荷会通过晶体管等路径缓慢泄漏。如果放着不管,过一段时间电容里的电荷量就会变得难以分辨,原本存的数据就毁了。
刷新操作的本质,就是在数据彻底丢失前,把存储单元里的数据先读出来,经过放大后再原样写回去,给电容补充流失的电荷,让数据得以“再生”。
有三种刷新方式,集中刷新,留出一段专门的时间刷新,期间不能访存。是的,这正是 DRAM 被称为易失性存储器的根本原因。
单个已存储芯片的容量有限,要组成大容量,就要连接多个芯片。
主存速度比CPU慢上百倍,因此在主存和cpu之间增加了cache也就是cpu缓存。这是由于时间和空间局部性。
时间局部性,刚被访问过的数据,很快会被再次访问,比如循环里的变量。空间局部性:刚被访问的数据附近的数据很快也会被访问,比如顺序遍历的数组。
cache和主存都被划分为大小相同的块。Cache中的块也叫Cache行。CPU访问数据时先查Cache,找到了叫命中,直接读;没找到叫缺失。就把主存中的整块数据调进Cache(cache miss)。
一个主存块一个放到哪一行?這就是映射方式,一共有三种。
直接映射,全相联,组相联。
- 直接映射,每个主存块只能放唯一的一行。行号=块号 mod 行数。它简单,速度快,但多个块抢同一行,冲突最多。
- 全相联映射:主存块可以放进任意一行,冲突最少,命中率最高,但是查找时,要和所有行的标记逐一比较。硬件代价最大。
- 组相联映射:俩者折中。把Cache分成若干组,组号等于块号除以组数的余数。组内可以随便放。
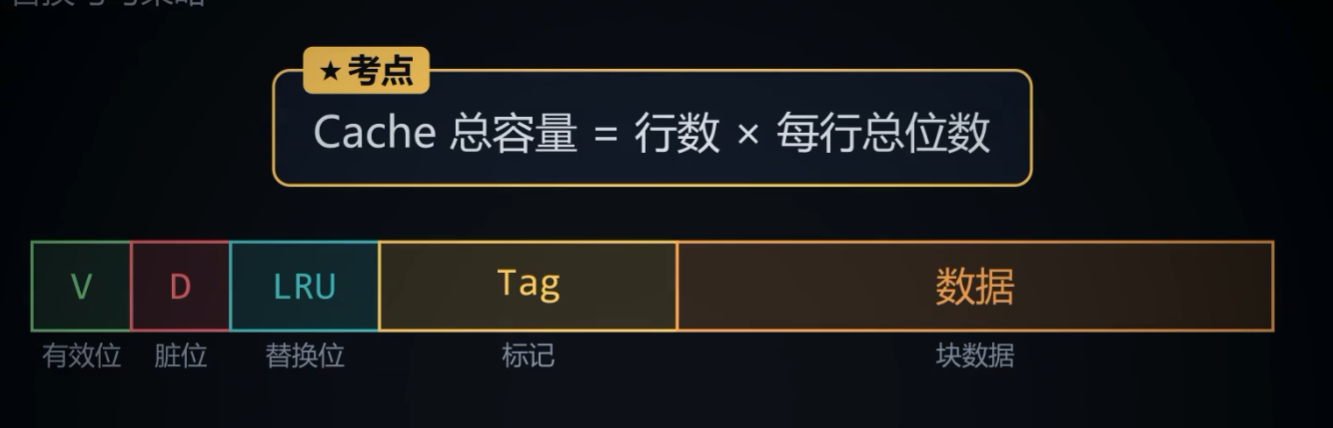
为了知道每一行装的是哪个主存块,每一行都要保存一个标记tag。和一个有效位,表示这一行的数据是否有效。
现代计算机中组相联映射用的最多,是绝对的主流选择。
Cache满了新块要进来,就要把旧块淘汰出去。直接映射没得选,位置是固定的。全相联和组相联才需要替换算法。常见算法有
RAND,FIFO,LRU,LFU。LRU是用的最多的,为了平衡性能成本,实际部署最广泛的是LRU的硬件简化版。
写策略:
当cache里的数据被修改了。主存里的那份怎么办?有俩种写策略。
- 全写法也叫写直通,写cache的同时。也写主存,俩边始终一致,但每次写都要访问慢速的主存。所以通常会加写缓冲来缓解。
- 写回法:只写cache,等这一行被替换出去时,才写回主存。为此,每行要增加一个脏位。记录这一行是否被修改过。写回发减少了访问次数,但主存和cache会短暂不一致。
写不命中时也有俩种做法。
写分配,先调cache再写,通常搭配写回法。
非写分配,直接写主存,不调块。通常搭配全写法。
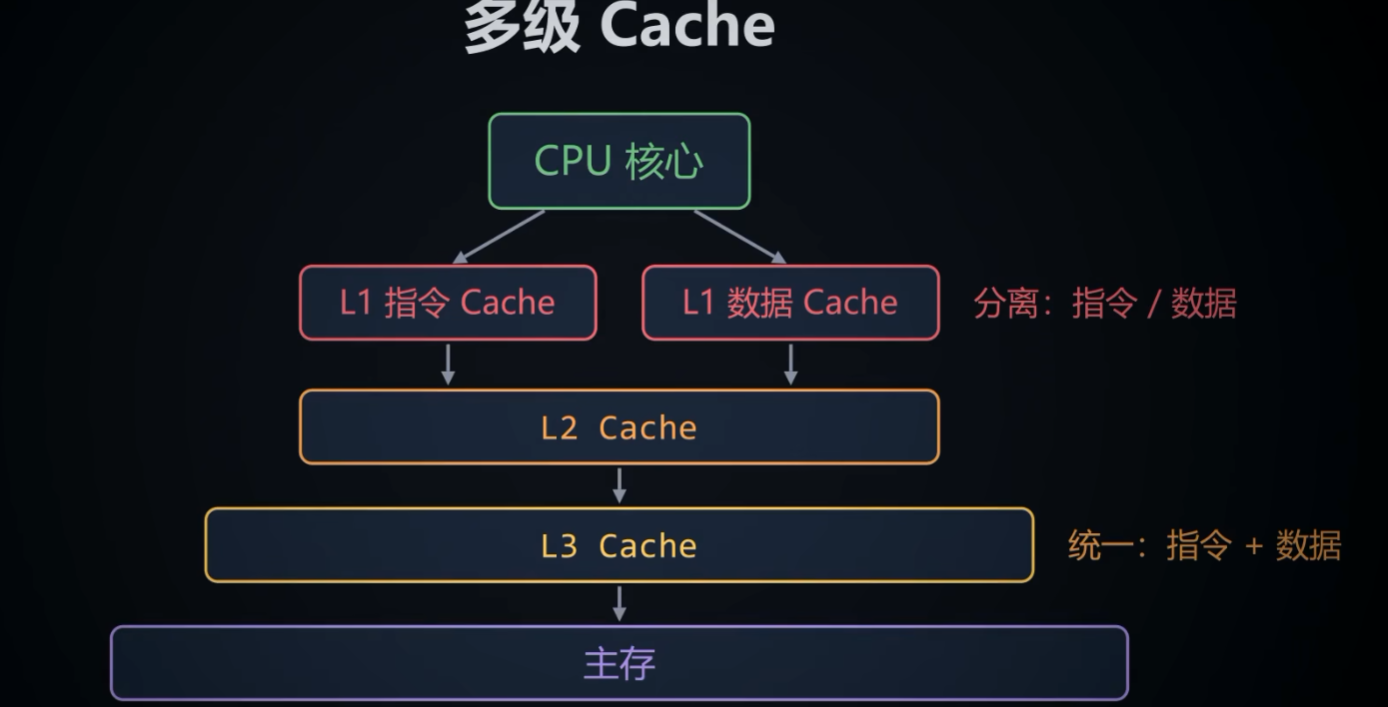
现在CPU通常有多级Cache,L1 cache存放指令cache,另一个L1存放数据cache。L2和L3更大一些,数据和指令放在一起。
指令
指令就是让计算机完成某种操作的命令,计算机所有指令的集合叫做指令系统,也叫指令集,是软件和硬件之间的接口。
指令分为操作码和地址码俩部分。操作码用于说明做什么操作,地址码说明操作数在哪里,以及结果放在哪里。
按地址码的个数,指令可以分成几类。
- 三地址指令,A1和A2的运算结果放在A3。如果地址都在主存,那么执行一次要访存4次,取指令一次,取俩个操作数俩次,存结果一次。
- 二地址指令:A1和A2运算,结果被放回A1
- 一地址指令:一个操作数在A1,另一个隐含在累加器ACC中。结果也放回ACC
- 零地址指令:不需要操作数。比如停机,空操作。或者操作数在栈顶。
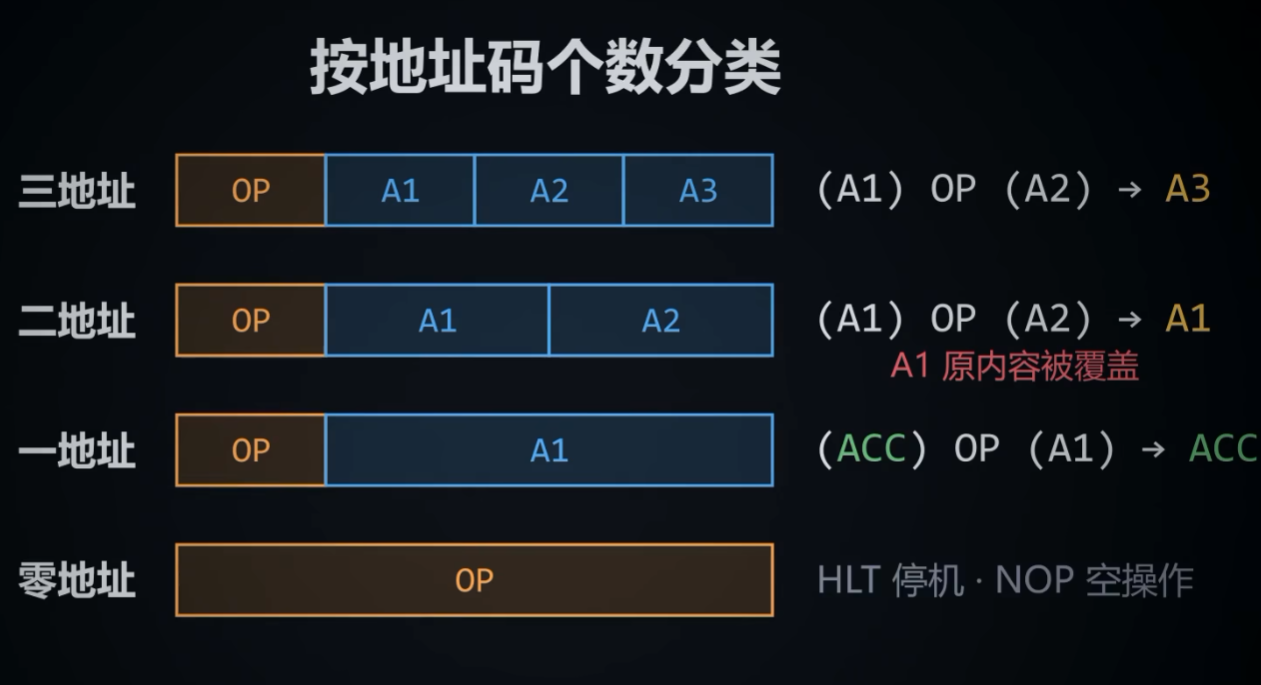
指令长度可以固定,叫做,定长指令(取址,译码方便)。也可以不固定,叫做变长指令,更节省空间。
操作码,长度可以一样,也可以不定长采用扩展操作码。
操作码是指令中用于指名该指令要执行什么操作的字段部分。比如加法,减法,存数,跳转等。
扩展操作码是一种变长操作码技术。它利用地址码字段中,空闲的位数来扩展操作码长度,从而在指令固定的前提下,实现更多中类的指令。
每一条指令都固定16位,每一个地址码,比如A1,A2,都固定占4位。
扩展原理:操作码(OP)的长度是可以变化的。为了区分不同的指令格式,设计者利用了地址码的部分位来扩展操作码。如果想要扩展,就得放弃一个地址码。
扩展操作码的核心目的是:在有限的指令字长内,尽可能塞进更多的指令类型,同时兼顾硬件解码的效率。
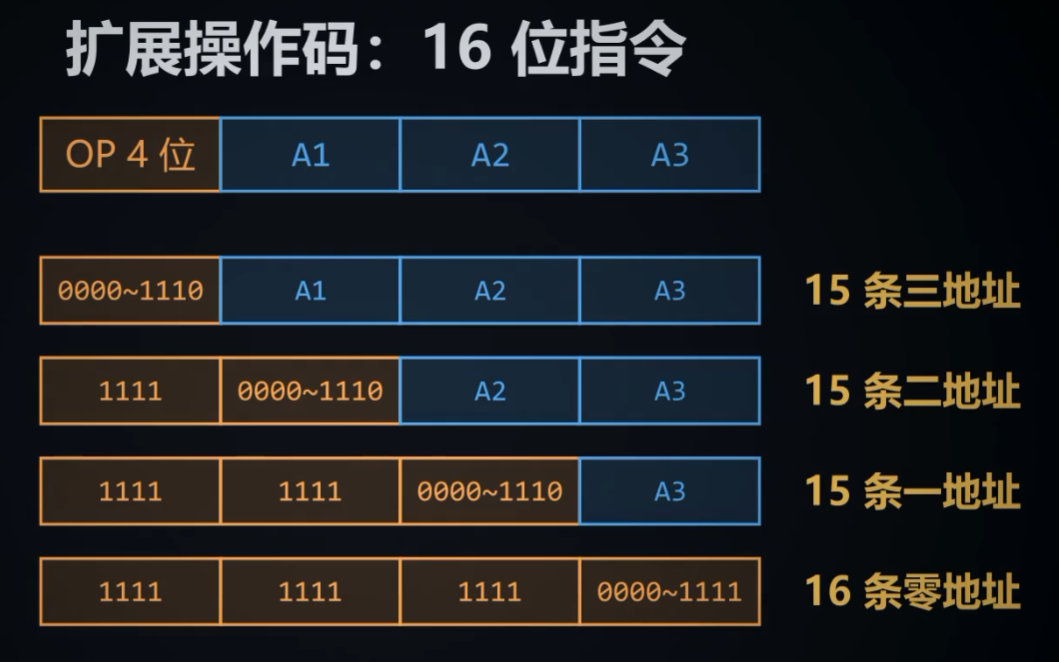
- 三地址指令(15条)
- 格式:
OP (4位) | A1 (4位) | A2 (4位) | A3 (4位) - 解释: 4位操作码 + 3个地址码(3×4=12位),正好16位。
- 操作码范围:
0000到1110(即十进制的 0~14)。 - 数量: 一共有 15 种组合。这就是 15条三地址指令。这种指令包含三个操作数,比如“A1 = A2 + A3”。
- 关键点: 为什么只到
1110就停了,不用1111?因为1111被保留作为“扩展标志”,告诉计算机:“看到这个操作码,说明这不再是三地址指令了,往下看后面的位。”
- 二地址指令(15条)
- 格式:
1111 (4位) | OP扩展 (4位) | A2 (4位) | A3 (4位) - 解释: 当第一段操作码是
1111时,就放弃 A1 这个地址码,把它用来做操作码的扩展。 - 操作码范围: 前4位固定是
1111,第2个4位(扩展部分)从0000到1110。 - 数量:
1111 0000到1111 1110,一共 15 种组合。这就是 15条二地址指令。比如“A2 = A2 + A3”。
- 一地址指令(15条)
- 格式:
1111 (4位) | 1111 (4位) | OP扩展 (4位) | A3 (4位) - 解释: 当第一段和第二段都是
1111时,说明连 A2 也不用保留了,继续把 A2 的空间拿来做操作码扩展。 - 操作码范围: 前8位固定是
1111 1111,第3个4位从0000到1110。 - 数量: 一共 15 种组合。这就是 15条一地址指令。
- 零地址指令(16条)
- 格式:
1111 (4位) | 1111 (4位) | 1111 (4位) | OP扩展 (4位) - 解释: 当前三段全都是
1111时,说明前面所有的地址码都被“吃”掉用来做扩展了,这条指令不包含任何地址码。 - 操作码范围: 最后剩下的 4 位可以取
0000到1111。 - 数量: 因为前面没有任何保留,这 4 位可以全用,即 24=1624=16 种组合。这就是 16条零地址指令。零地址指令通常用于无操作数的情况,比如“停机”、“空操作”等。
- 如果你想拥有最多的 3 地址指令,你最多只能设计 16 条(如果把 1111 也用掉),但为了兼容 2 地址、1 地址和 0 地址,你必须牺牲一种 3 地址的编码(也就是
1111)来作为“门牌号”,带你进入下一层(2地址指令)。 - 同理,每一层都牺牲一个
1111作为下行通道,最终形成了15 + 15 + 15 + 16 = 61条指令的指令集。
其实这样设计之后,这4位0000到1111原本有16种可能,但3地址指令只用了15种,硬生生的少掉了一种可能。在这里1111就像一个前缀标志。当译码器看到前4位是1111时,不会把它当一个普通的三地址指令去运行。扩展操作码的原则是,端操作码不能是长操作码的前缀,否则译码时无法区分。
按功能区分指令有
- 收数据传送 mov
- 算数逻辑 add and
- 移位 shl sar
- 转移 jmp jxx call ret
- 输入输出 in out
条件转移根据标志位决定是否跳转。
指令中的地址码,往往不是操作数真正的地址。要经过一定的计算才能找到操作数所在的位置。这个位置叫做有效地址EA。找操作数的方法,就是寻址方式。
指令中能直接给出的地址字段长度有限,而内存空间可能很大;同时程序还需要支持基址、变址、相对寻址、等灵活机制。因此,指令中的地址码通常只是形式地址(A),需要经过寻址方式和地址变换才能得到有效地址(EA),再由 EA 访问内存取得操作数。
寻址分为俩类。指令寻址,是找下一条指令,顺序执行时,pc自动+1。跳转时,由转移指令把目标地址送进pc。数据寻址是找操作数,花样就多了。
- 直接寻址:EA = A。这时地址码恰好就是操作数的真正地址,但这是特例。
- 间接寻址:EA = (A)。地址码 A 指向一个内存单元,该单元里存放的才是操作数的地址。
- 基址寻址:EA = (BR) + A。A 是偏移量,不是真正地址。BR是基址寄存器
- 变址寻址:EA = (IX) + A。A 同样是形式地址或偏移。
- 相对寻址:EA = (PC) + A。A 是相对于当前指令地址的位移量。常用于转移指令,这里的PC是取出本条之类后已经更新过的值。
- 寄存器寻址:操作数在寄存器中,地址码字段可能只是寄存器编号,根本不对应内存地址。
变址寄存器(index register)是计算机中用于变址寻址的一种专用通用寄存器,起内容在地址计算中作为基准值或偏移量,与指令中的形式地址相加,形成操作数的有效地址。
EA=(IX)+A
IX:变址寄存器内容
A:指令中的形式地址(偏移量)
还有基址寄存器。EA=BR+A,BR就是基址寄存器。形式上和变址一样。但是BR由操作系统管理。程序执行期间不变。用来实现程序的浮动和重定位。
变址寄存器内容由用户设定,内容可变。特别适合处理数组。
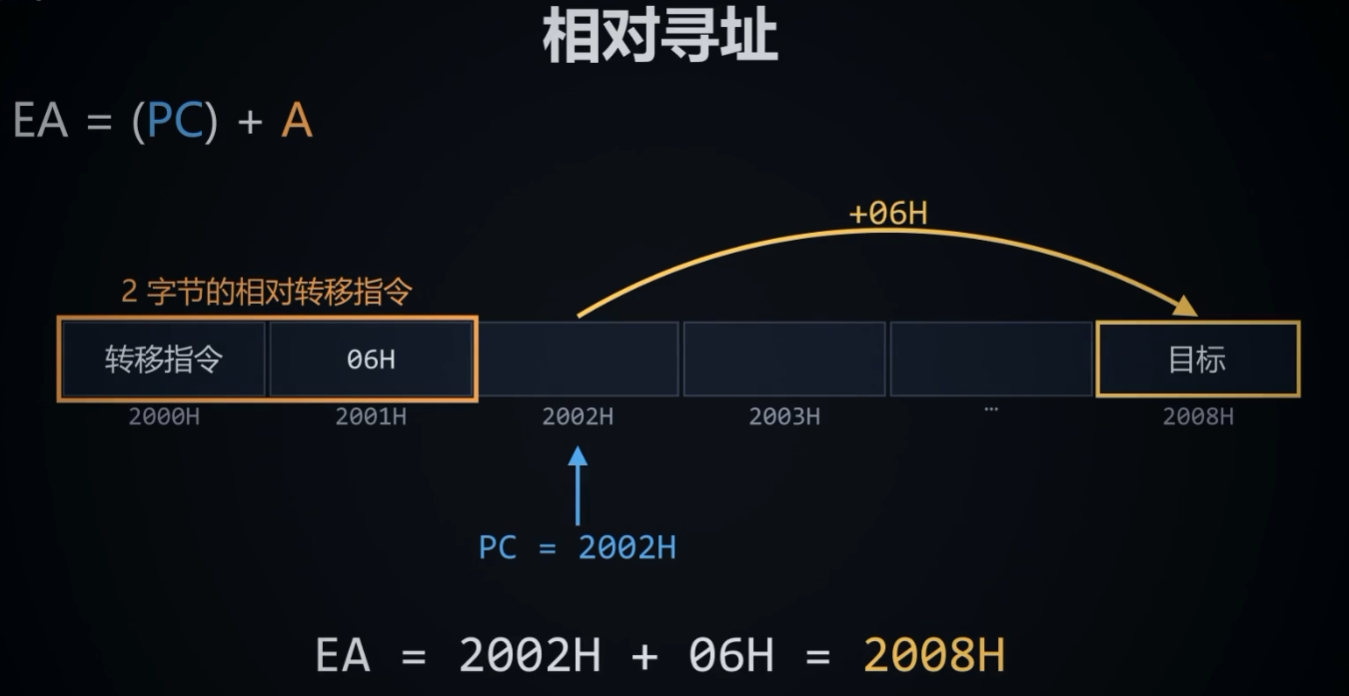
堆栈寻址:操作数在栈顶,由栈指针,sp隐含指出,进栈、出栈时sp自动加减。
这些寻址方式在x86汇编中随处可见。
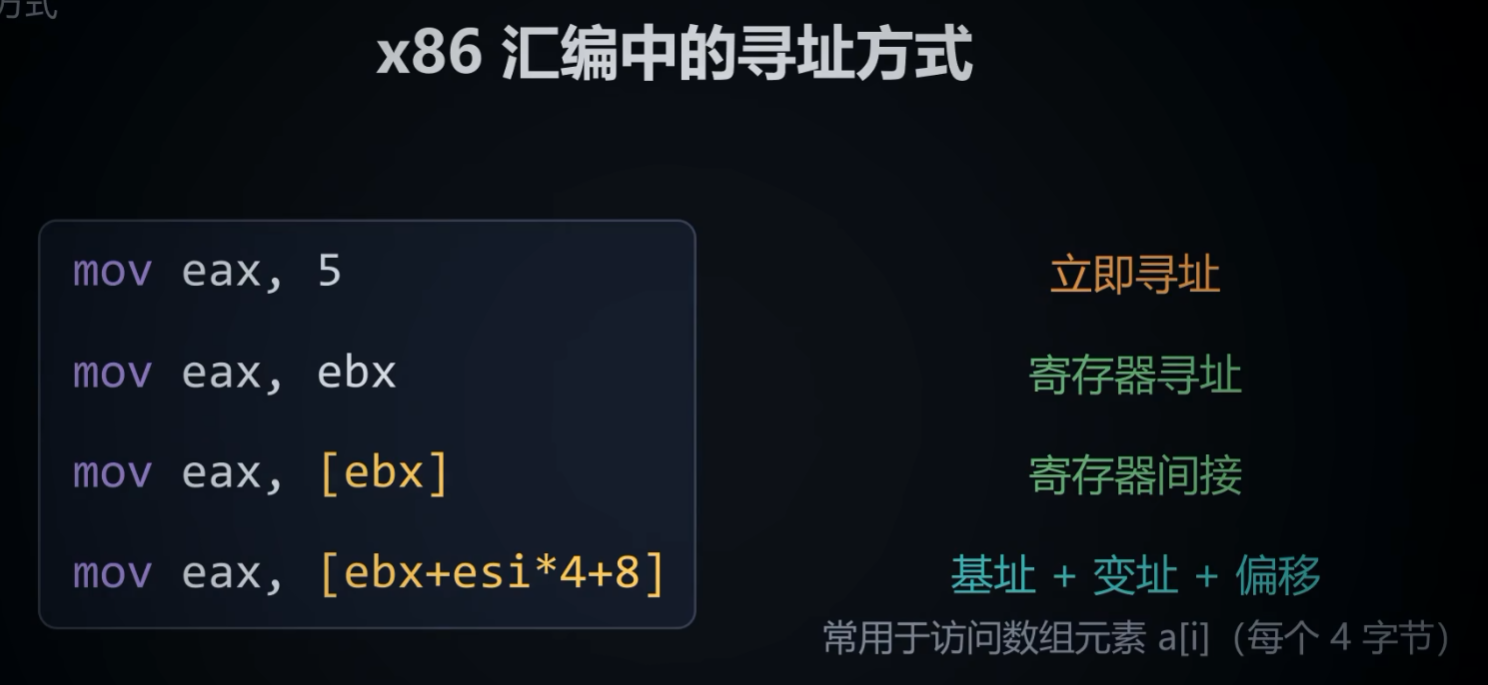
从指令系统的设计风格来看有2大流派,CISC和RISC
| 对比维度 | CISC 复杂指令集 | RISC 精简指令集 |
|---|---|---|
| 指令数量 | 多 | 少 |
| 指令长度 | 可变 | 定长 |
| 寻址方式 | 丰富 | 简单 |
| 访存 | 很多指令都能访存 | 只有 Load / Store |
| 寄存器 | 较少 | 多 |
| 控制方式 | 微程序为主 | 硬布线为主 |
| 流水线 | 较难 | 非常适合 |
| 代表 | x86 | ARM · RISC-V |
RISC的出发点是28定律,程序80%的时间在执行20%的简单指令,RISC只有load和store指令访问存储器,其余运算都在寄存器之间运行。
在 x86 中,像 ADD、MOV、XOR 这样的双操作数指令,通常允许其中一个操作数在寄存器或内存中,另一个操作数在寄存器或作为立即数。具体允许的组合包括:寄存器到寄存器、寄存器到内存、内存到寄存器、立即数到寄存器、立即数到内存。这意味着一条 ADD [mem], eax 就可以直接完成“读内存、相加、写回内存”,而 RISC 必须拆成 load、add、store 三条指令。
CPU结构和指令周期
CPI的功能可以概括为5个
- 指令控制:保证指令按顺序执行
- 操作控制:产生每条指令需要的操作信号
- 时间控制:安排这些信号的先后,数据加工。做算数和逻辑运算
- 终端处理:响应异常。
CPU由运算器和控制器俩大部分组成。
运算器负责数据加工。核心是算数逻辑单元ALU还有累加器ACC,通用寄存器组、暂存寄存器。以及记录运算结果特征的程序状态字寄存器PSW。
控制器是指挥中心:程序计数器PC存放下一条指令的地址。指令寄存器IR存放正在执行的指令。指令译码器分析操作码。时序下同和操作新好发生器,按时间顺序发出控制信号。还有和主存打交道的MAR和MBR。
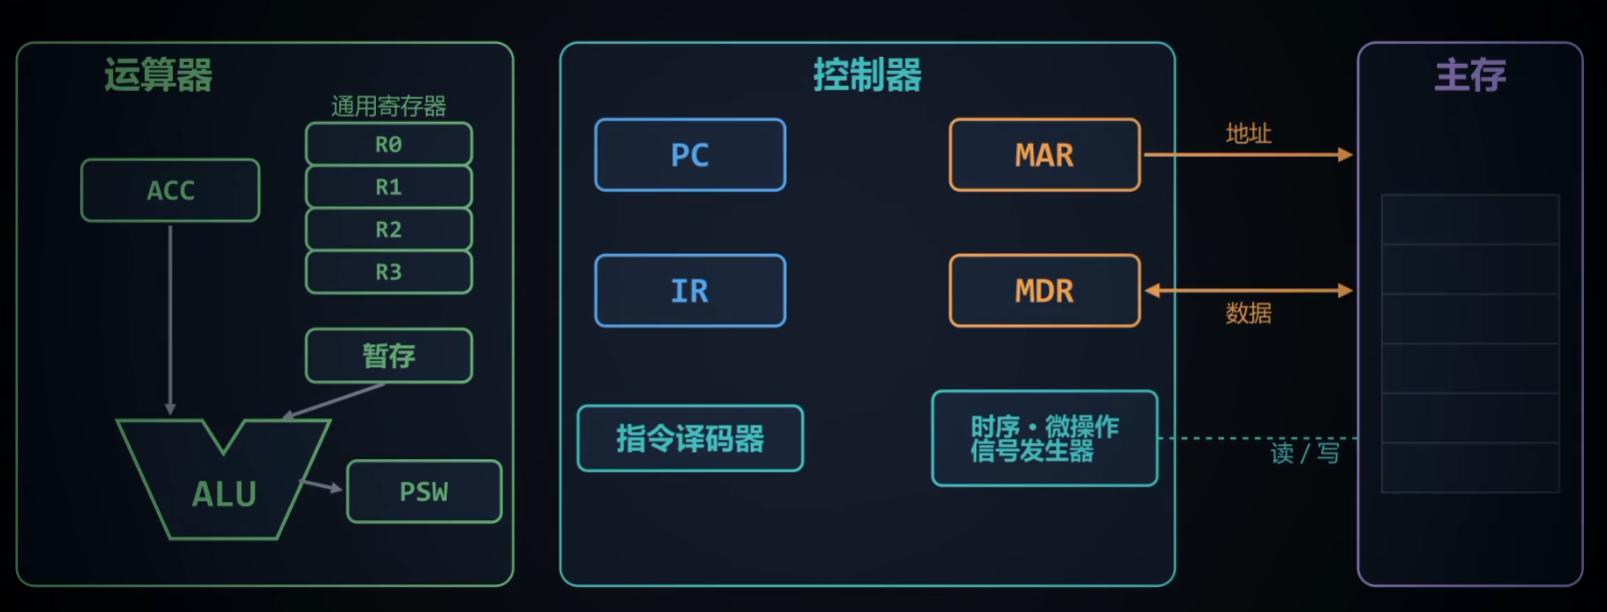
哪些寄存器对程序员可见呢?汇编程序里,能直接访问的PC,通用寄存器,PSW是可见的。IR,MAR,MDR和暂存器是不可见的。
CPU取出并执行一条指令的全部时间叫做指令周期。它由若干个机器周期组成。每个机器周期又包含若干个时钟周期。
一个完整的指令周期最多有四个阶段。
- 取址周期,取出指令。
- 间址周期,取有效地址。
- 执行周期,执行指令。
- 终端周期,如果有中断请求, 就响应中断。
取址、执行:每条指令都有。间址周期只有间接寻址才有。中断周期,只有在有专断请求,并且允许终端时才能进入。
所以不同指令周期的周期长度可以不同。
CPU 中断主要发生在两类情况:外部硬件发出请求,或 CPU 内部执行指令时触发了异常/系统调用。简单说,就是“外面有事找它”或者“它自己遇到了状况”。
硬件中断(来自 CPU 外部)
这类中断通常是异步的,与 CPU 当前执行的程序无关。I/O 设备请求:当键盘、鼠标、硬盘、网卡等外部设备完成操作或需要 CPU 处理数据时,会发出中断请求。
时钟中断:硬件定时器以固定频率发出中断,用于操作系统的时间片轮转、任务调度等。
硬件故障:如电源掉电、内存故障等紧急情况。这类通常属于不可屏蔽中断,CPU 必须立即处理。
软件中断 / 内部异常(来自 CPU 内部)
这类中断通常是同步的,由正在执行的指令直接引起。程序故障(异常):执行指令时出错,如除数为零、非法指令、地址越界(访问了无权访问的内存)、浮点溢出等。
系统调用:用户程序主动执行一条特殊指令(如 int 或 syscall),请求操作系统提供服务(如读写文件)。这通常是“自愿中断”。
此外,在多处理器系统中,一个 CPU 还可以向另一个 CPU 发送处理器间中断,用于协调工作或同步。
数据通路
数据在各个部件传输的路径叫做数据通路。最简单的是单总线结构。所有寄存器和ALU都挂在CPU内部的一条总线上。每个寄存器都有输入控制信号和一个输出控制信号。
CPU的暂存器通常归为寄存器的一种。核心作用是指令执行的过程中,临时存放数据或地址,作为高速的中转站,以支持算数逻辑单元(ALU)完成运算,避免频繁访问较慢的主存。
它并不长期保存数据,内容往往在操作周期结束后就被覆盖或替换。
专用数据通路速度快,但硬件量大。单总线,结构简单,但冲突多,速度慢。
控制器有俩种设计方式来产生控制信号。
- 硬布线控制器:组合逻辑电路,直接产生控制信号。速度快,电路复杂,男修改难扩冲适合RSIC
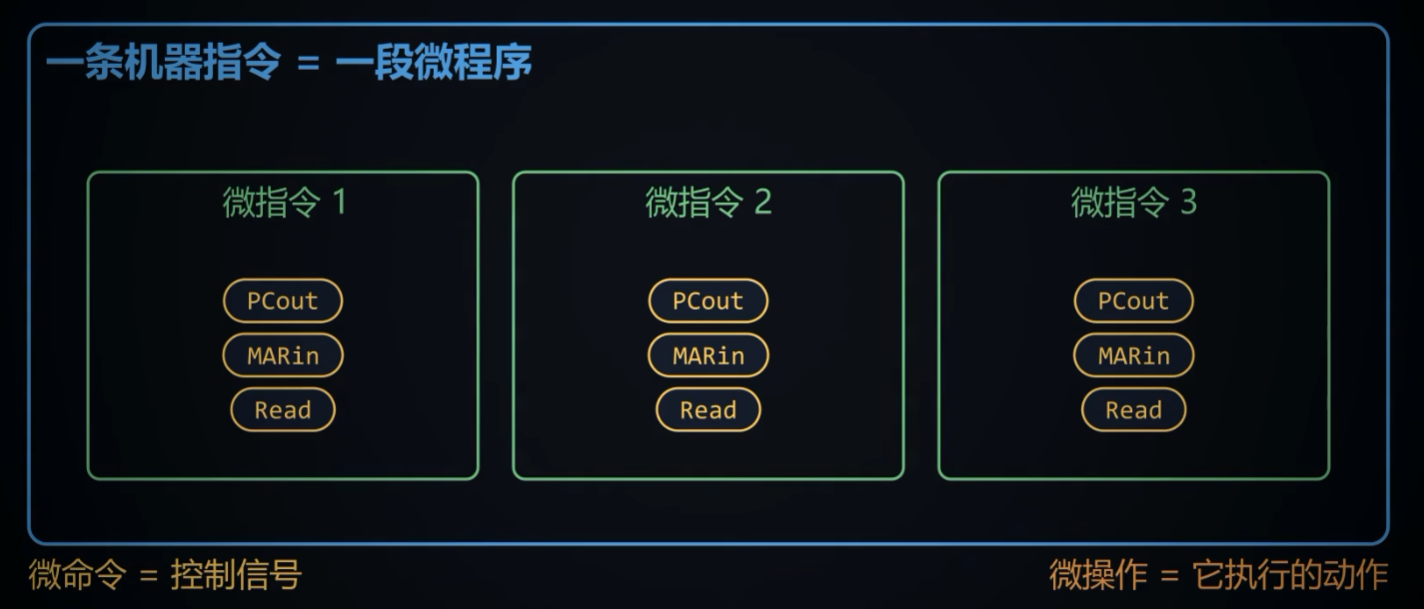
- 微程序控制器:微程序控制器借鉴了程序设计的思想。把每条机器指令拆成了一系列微操作。写成一段微程序了,存放在控制存储器CM里。执行指令时,一次取出微指令,发出控制信号。
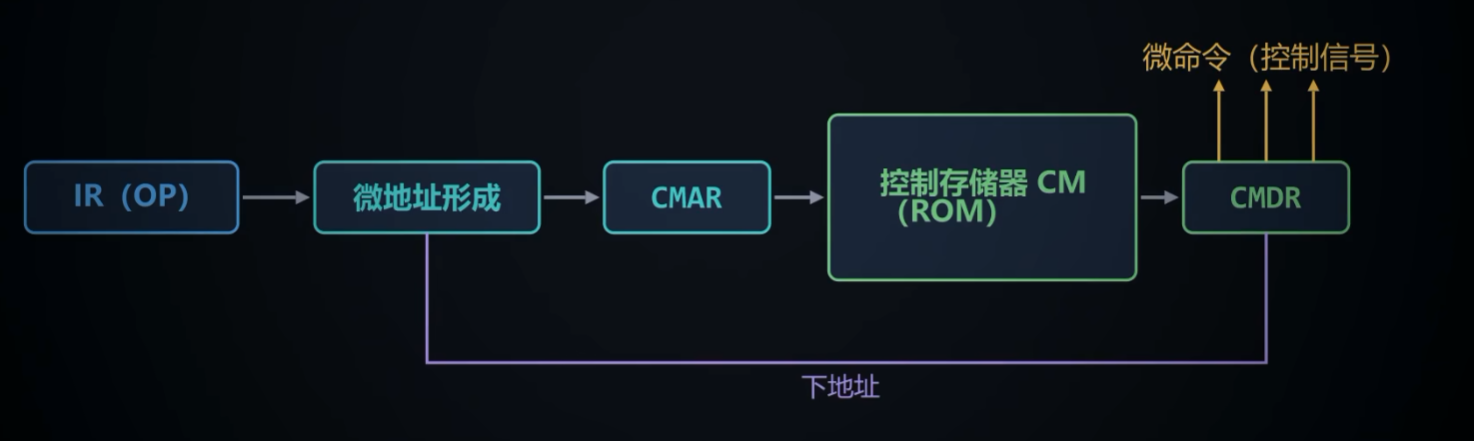
这里的概念层层嵌套,一条机器指令对应一段微程序。一条微指令包含多个微命令。
现代x86处理器是用混合设计,绝大多数常见指令由硬件连线逻辑直接编码,只有复杂或极少用到的指令才动用微码(微程序)。
ARM 的情况和 x64 有相似之处,但整体上比 x64 更偏向“硬连线”。传统上 ARM 被视为典型的 RISC 架构,设计哲学就是用简单的硬连线逻辑解码指令,而不是依赖微程序。
计算机中的ROM是什么
ROM 是 Read-Only Memory 的缩写,中文叫只读存储器。
它是计算机中的一种非易失性存储器——断电后数据不会丢失。与 RAM(随机存取存储器)不同,ROM 在正常使用中通常只能读取、不能随意写入,主要用于存放固定不变的程序和数据。
在微程序控制的CPU中,每条机器指令的执行不是由硬连线逻辑直接产生控制信号,而是由一段存储在控制存储器(Control Store,通常是ROM)中的微程序来解释执行。微程序由若干条微指令组成,每条微指令对应一个时钟周期内要发出的一组控制信号。
这样设计的核心思想是:把控制逻辑"软件化"——用存储的微代码代替复杂的组合逻辑电路,使CPU控制部分规整、易修改、易扩展。
控制存储器通常是通过ROM实现。在CPU内部存放微程序。不同于主存,主存存放的是用户程序和数据。
微程序控制器,规整,灵活,便于修改。缺点是比硬布线慢。
微指令分为俩种格式
- 水平型:一条并发出多个微命令,字长长,速度快
- 垂直型:像机器指令一样,一条只做一俩个微操作,字长短,速度慢。
在微指令编码语境里,互斥指的是:俩个或多个微命令在同一个微周期内不可能,也不允许同时发出。也就是说,他们在逻辑上或硬件资源上是二选一的关系。
与之相对的是相容:两个微命令可以同时发出而不冲突。例如“打开总线”和“ALU 执行加法”可以同时进行,因为它们控制的是不同部件、不争用同一资源。
下一条的微指令地址如何确定?
可以和PC一下直接+1,也可以在微指令里面专门放一个下地址字段。
指令流水线
经典的五段指令流水线
取址,译码,执行,访存,写回。
我们画成时空图,横轴是时间,纵轴是指令。流水线装满之后。每个时钟周期都有一条指令完成。
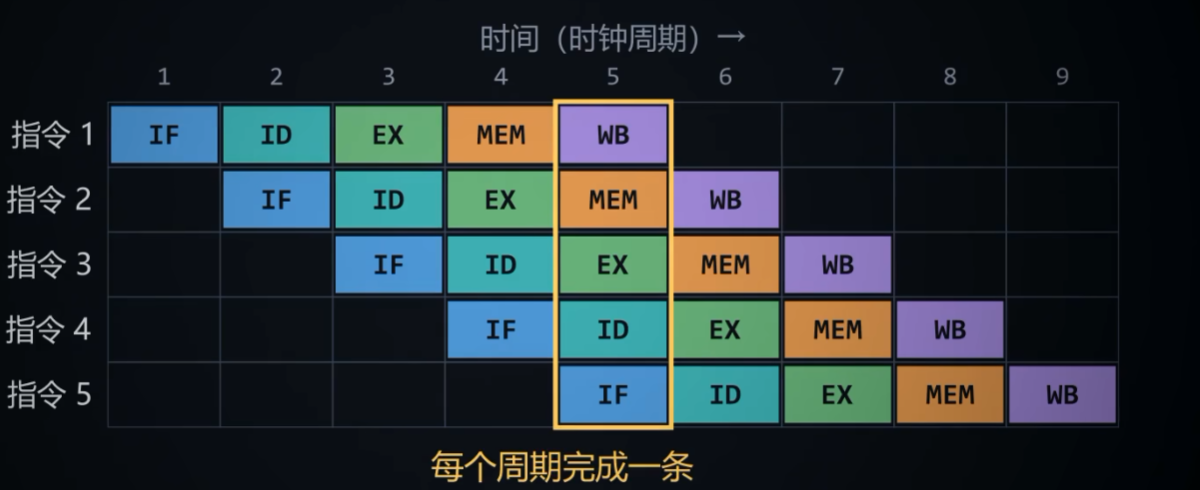
五个指令在同一个时钟周期,都有色块。总结就是在一个CPU核心内部,不同硬件模块在同一时刻鸽子处理不同指令的不同阶段。
如果各段时间不相等,最慢段是瓶颈。流水线是纵向分工,超标量是横向加宽。上面演示的是每个周期只发出一条指令的情况。
流水线不能缩短单条指令的执行时间,反而更慢(迁就慢段+端间寄存器),它提高的是吞吐率。
流水线最适合RISC,那样定长,格式规整,只有load和store访存的指令。
现实中流水线常常被打断,这些情况叫冒险,也叫相关。一共有三种。
- 结构冒险:硬件资源冲突,比如一条指令在访存段要读数据,一条指令在取址段要从存储器取指令。俩者抢同一个存储器。解决方法是把指令cache和数据cache分开。
- 数据冒险:要用的数据还没算好。后一条指令要用前一条指令的结果,但是结果还没写回。
第一条add把R2+R3的结果写入R1。第二条sub马上要读R1 。add要到第五个周期才把结果写回R1。而sub在第三个周期就要读R1.
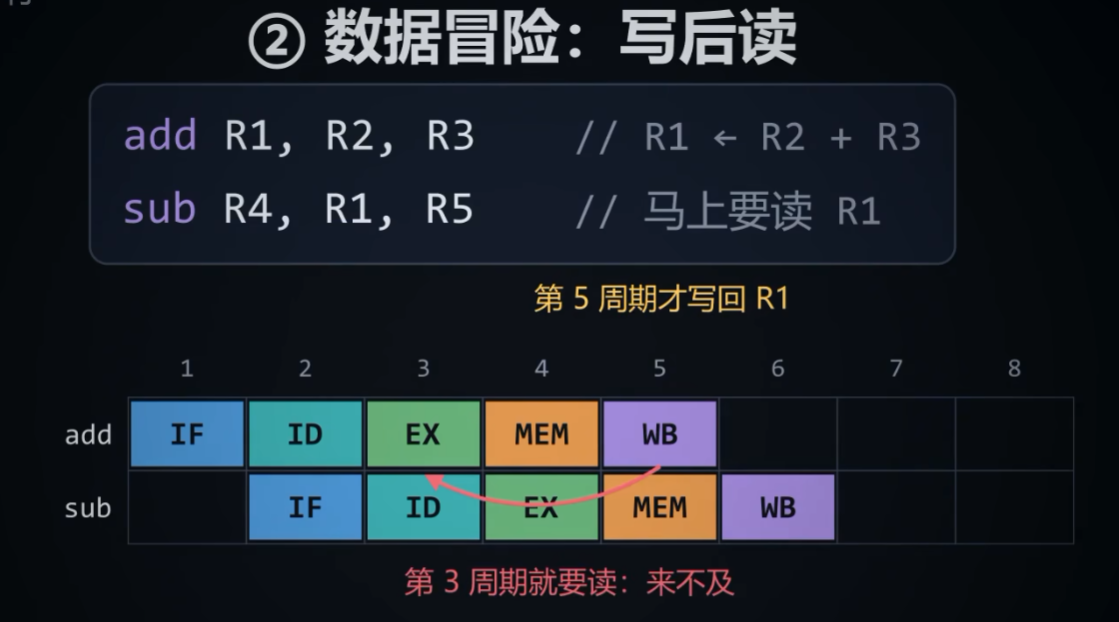
最简单的办法是让sub停下来等,插入气泡。假设寄存器在一个周期的前半段写,后半段读,就要插入俩个气泡。更好的方法是数据旁路,也叫转发。add在EX结束时已经算出了结果。直接把它送到sub的EX端输入端。不用等写回,一个气泡都不用插。
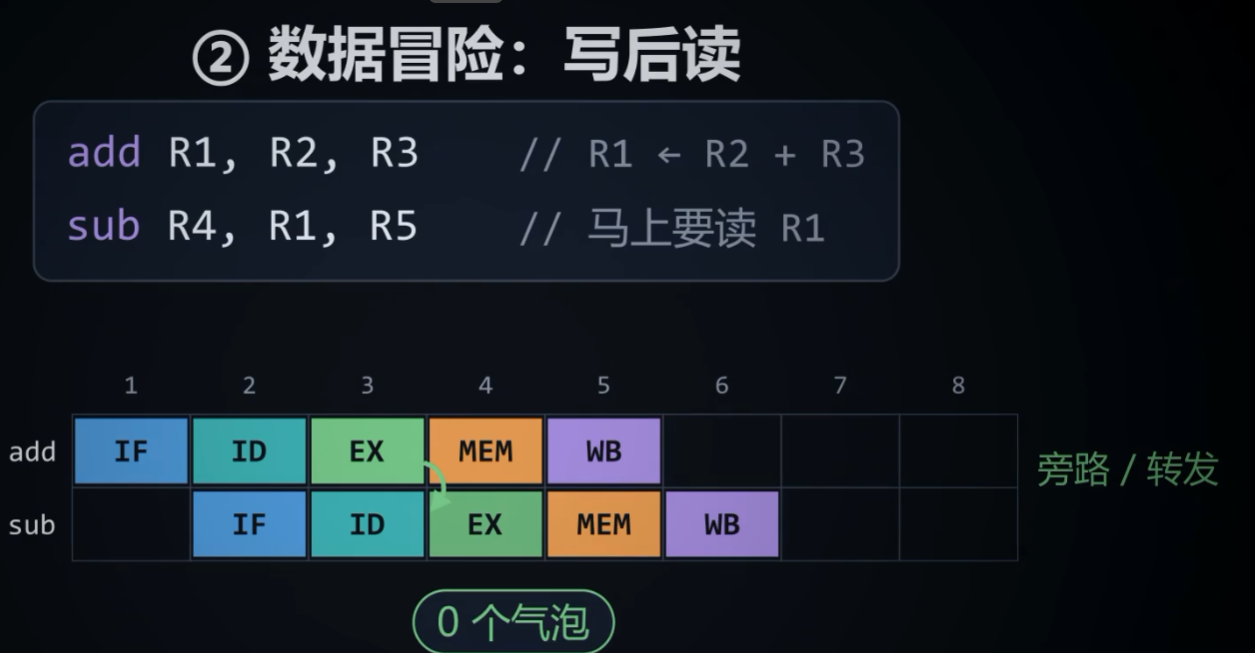
但又一种情况转发也救不了。load指令要到MEM段结束才能拿到数据,如果下一条指令马上要用,仍然要停顿一个周期。这叫load use冒险。编译器可以通过调整指令顺序来避免。数据冒险主要是写后读。
| 类型 | 含义 | 顺序流水线 |
|---|---|---|
| RAW 写后读 | 后一条读前一条写的结果 | <span style="color:red;">会出现</span> |
| WAR 读后写 | 后一条写前一条要读的 | 只在乱序执行 |
| WAW 写后写 | 两条写同一个寄存器 | 只在乱序执行 |
- 控制冒险:转移指令,不知道下一条取哪条
控制冒险由转移指令引起。要等转移指令执行到一定阶段。才知道下一条取哪条指令。
解决办法有暂停等待,分支预测:静态,根据历史记录动态预测。延迟转移:分支后方一条必执行的指令。
为了更快,现在CPU里还有更多的招数,比如
- 超标量,在CPU里放多跳流水线。
- 超流水线,把流水线份的更细段数更多。从而提高主频。
- 超长指令字,编译器把多个可以并行的操作打包成一条长指令。
Flynn分类法
从更大的范围看,按指令流和数据流。计算机可以分为4类。
| 指令流 / 数据流 | 单数据流 (Single Data) | 多数据流 (Multiple Data) |
|---|---|---|
| 单指令流 (Single Instruction) | SISD 单核处理器 | SIMD 向量处理器 · GPU |
| 多指令流 (Multiple Instruction) | MISD 几乎没有 | MIMD 多核 · 多处理器 |
SIMD使用的是数据集并行。
总线
计算机中的部件,如果俩俩之间都单独连线,那么线就太多了。使用公用的传输线,把它们都连在一起,同一时刻,总线上只能有一个部件发送。但可以有多个部件接收。
总线分类,按连接的部件
- 片内总线:在芯片内部,比如CPU内寄存器之间
- 系统总线:连接CPU,主存和IO接口。
- 通信总线:连接计算机和其他系统设备,比如usb
系统总线按照传输的信息分为三种。
- 数据总线,传输地址,是双向的
- 地址总线,传输地址是单向的
- 控制纵向,传输控制信号,比如读写命令,中断请求。
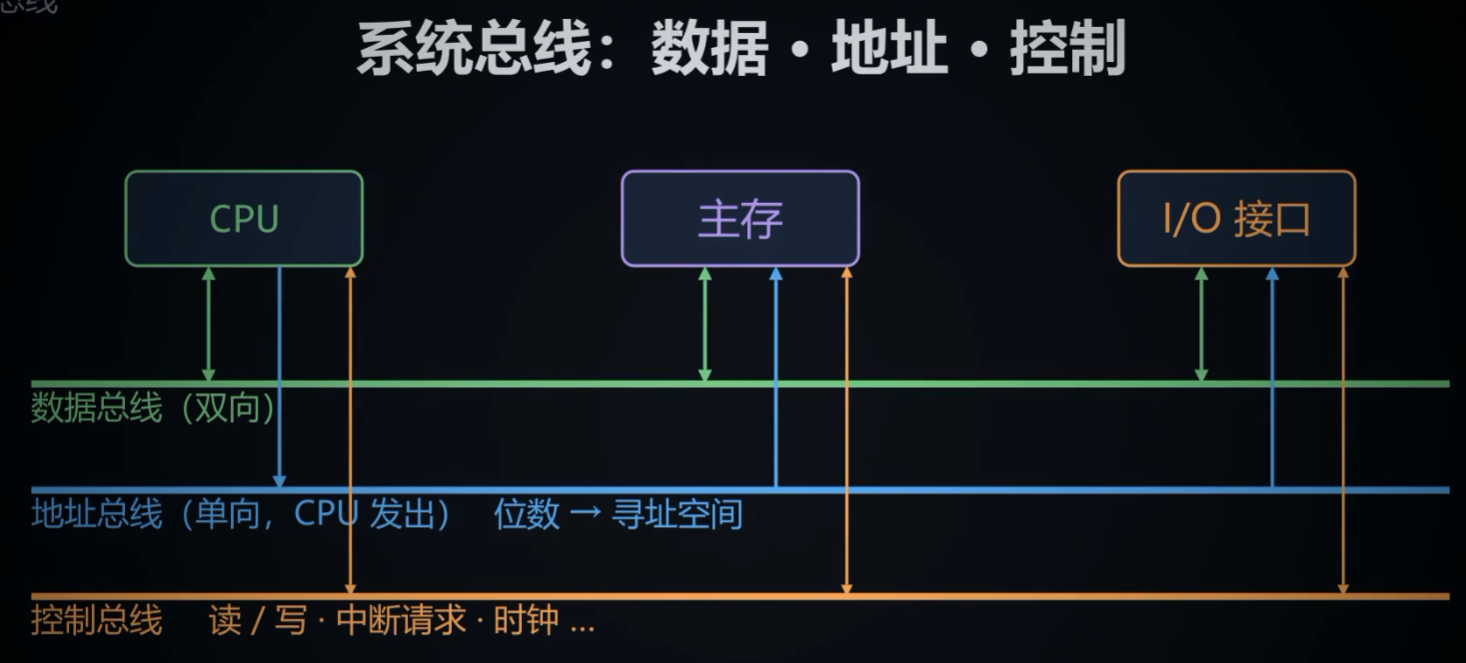
地址总线n根就能访问2^n次方个存储单元。数据总线宽度决定一次能传多少位。
按结构分
- 单总线:cpu,主存,io设备都挂在一条总线上。简单容易成为瓶颈。
- 多总线:让高速和低速设备分开走,效率高。现代计算器多采用以桥接芯片为核心的层次结构。比如PCIE总线。
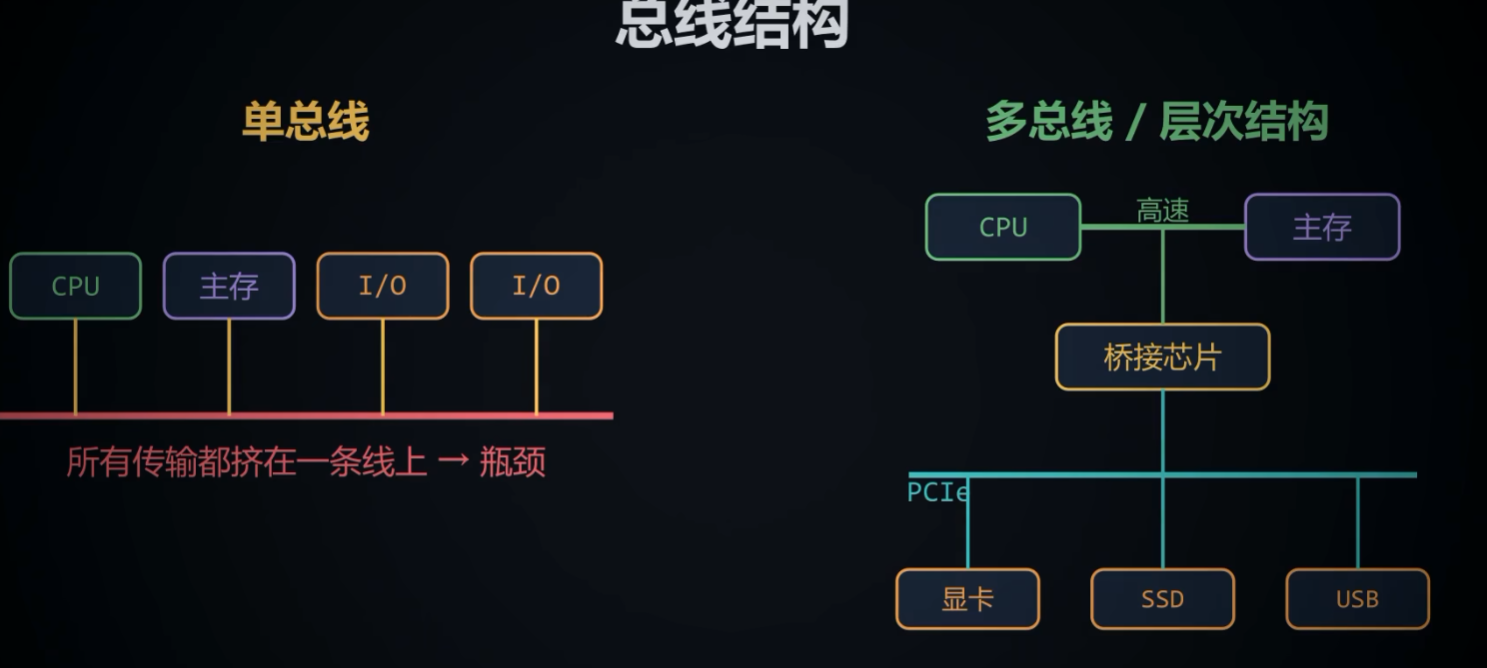
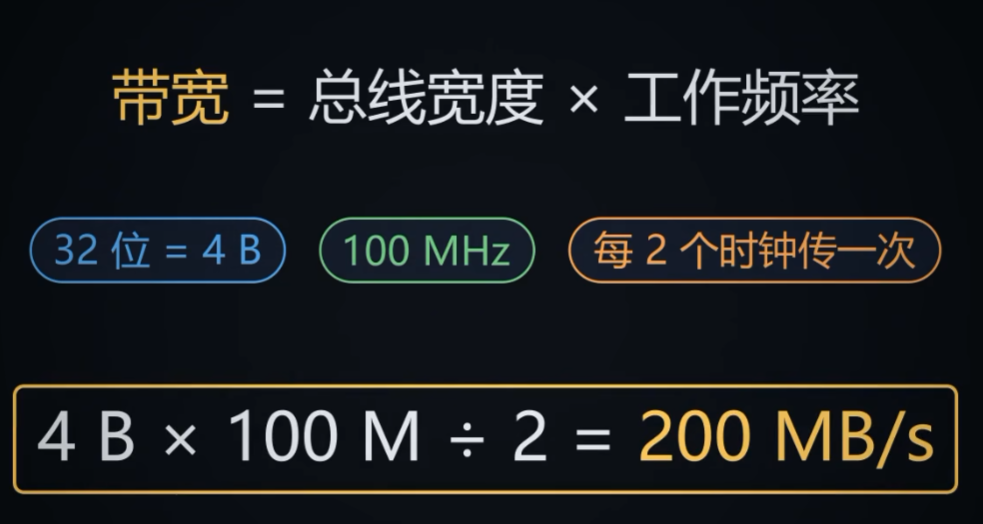
总线的性能直播有:总线宽度。也就是数据线的根数;总线工作频率,以及最重要的总线带宽。即每秒能传输的数据量。
带宽=总线宽度x工作频率。
多个部件同时想用总线。由总线仲裁决定谁先用。
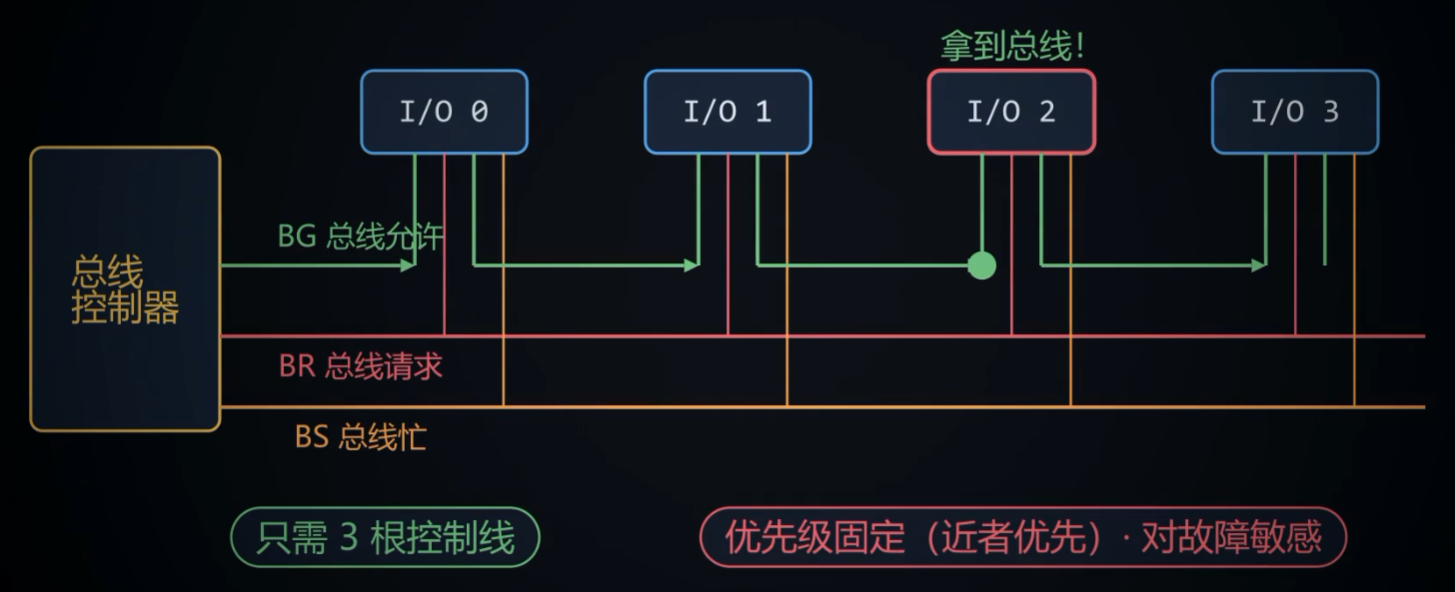
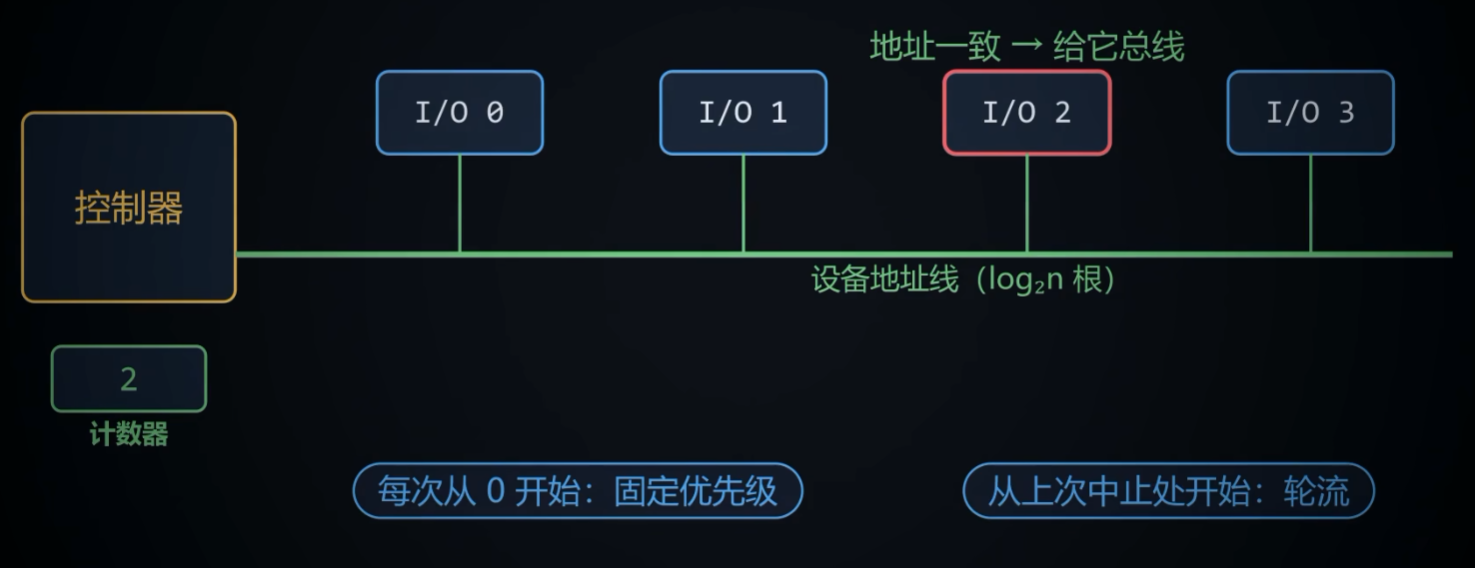
这里的仲裁有三种方式。
- 链式查询,总线允许信号像接力棒一样。从离控制器最近的部件开始依次往下传。谁先拿到,并且有请求,谁就使用总线。只需要三根控制线,里的越近越优先,而且对电路故障很敏感。
- 计数器定时查询。控制器用计数器依次发出设备地址。和发出请求的设备地址一致。就把总线给它。计数器可以每次从0开始。也可以从上次停下的地方开始。
- 独立请求,每个设备都有自己ID请求先和允许线。由控制器里的排队电路直接裁决。响应最快,但控制线最多。
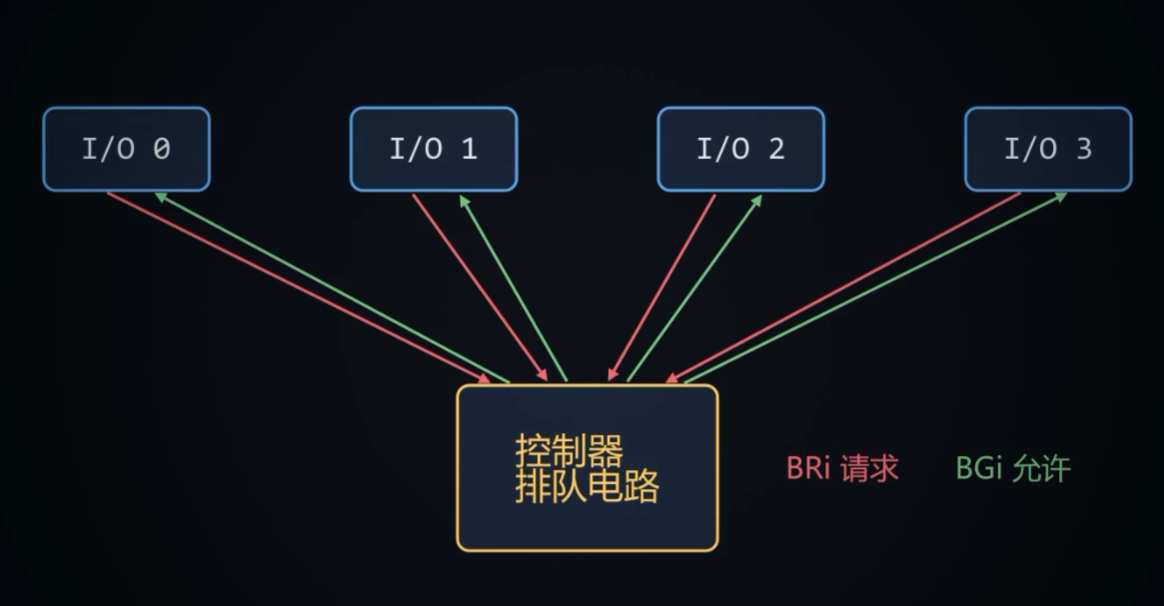
在现代计算机中独立请求与准许结构是现代总线标准普遍采用的集中式仲裁方式。
最后是总线定时。
- 同步定时:双方都听同一个时钟指挥。但只适合距离短,速度相近的部件。
- 异步定时:没有统一的时钟,靠请求和回答俩个信号握手。根据这俩个信号是否互相锁定,又分为不互锁,半互锁,全互锁。全互锁最可靠。
- 半同步通信:在同步的基础上,加一个等待信号。让慢速设备可以申请延长时间。以及分离式通信。
- 分离式通信:在等待设备准备数据的期间。把总线染个给别人使用,录用率最高。
IO
IO设备种类繁多,速度差异巨大,不能直接介入到总线上,中间需要有一个IO接口。也叫IO控制器,接口的作用是数据缓冲。匹配主机和外设的速度;格式转换。比如串行和并行之间转换。转送控制命令和状态信息。接口里能被CPU直接访问的寄存器叫端口,包含数据端口,状态端口,控制端口。
端口怎么编址?
端口编址要解决的核心问题是,CPU如何找到某个特定的端口?端口 如何与内存地址空间协调。
统一编址:把端口当做主存单元一样编址。用普通的访存指令访问,比如MOV。整个地址空间中画出一部分区域给I/O端口,端口地址和内存地址处于同一个地址空间,共用同一套总线地址。cpu不需要区分这是内存地址还是端口地址,它只需要知道访问地址X。用普通访存指令即可访问端口。ARM架构几乎全部采用统一编址。
| 优点 | 说明 |
|---|---|
| 指令集简单 | 不需要专门的 I/O 指令,复用访存指令,RISC 架构友好 |
| 编程灵活 | 可以用任何寻址方式(寄存器间接、变址、立即数等)访问端口 |
| 访问速度快 | 可使用流水线、缓存优化(但 I/O 通常需绕过缓存) |
| 地址空间大 | 端口可用全部地址位宽,端口数量不受限制 |
| 缺点 | 说明 |
|---|---|
| 占用内存地址空间 | 端口区占用了宝贵的内存地址空间 |
| 难以区分 | 程序无法从指令上区分访存还是访 I/O,调试/保护较难 |
| 需地址译码区分 | 硬件上要译码地址范围来选中内存还是设备,译码逻辑较复杂 |
| 缓存一致性问题 | I/O 区域必须标记为不可缓存(uncacheable),否则读写会被缓存"吃掉" |
独立编址:端口有自己独立的地址空间。端口有独立的地址空间,要用专门的IO指令访问。比如x86的in和out。
I/O 端口拥有自己独立的地址空间,与内存地址空间完全分离。CPU 的地址总线在访问内存和访问端口时是复用的(或通过控制信号区分),但两者地址编号互不干扰——内存的 0x100 和端口的 0x100 是两个不同的东西。
x86也支持统一编址,如显存,pci设备的MMIO区域。是俩种方式并用的混合架构。
| 优点 | 说明 |
|---|---|
| 不占用内存地址空间 | 内存地址空间完整留给内存 |
| 指令层面可区分 | IN/OUT 与 MOV 泾渭分明,便于保护、调试、模拟 |
| 端口数量少、译码简单 | 端口地址位宽小(如 16 位),硬件译码逻辑简单 |
| 无需考虑缓存问题 | I/O 指令天然不经过数据缓存,语义清晰 |
| 缺点 | 说明 |
|---|---|
| 需要专门指令 | 指令集增加 I/O 指令,RISC 架构通常不愿这么做 |
| 寻址方式受限 | IN/OUT 通常只能使用立即数或 DX 寄存器间接寻址,灵活性差 |
| 端口数量受限 | 受地址位宽限制(x86 仅 64KB) |
| 编程不便 | 不能用通用访存指令和高级语言指针直接操作 |
| 对比维度 | 统一编址(Memory-Mapped) | 独立编址(Isolated) |
|---|---|---|
| 地址空间 | 与内存共用 | 独立于内存 |
| 访问指令 | 普通访存指令(MOV/LOAD/STORE) | 专门 I/O 指令(IN/OUT) |
| 地址位宽 | 全部地址位宽,端口数多 | 通常较小(x86 为 16 位) |
| 寻址方式 | 丰富灵活 | 受限 |
| 指令集复杂度 | 简单 | 需增加 I/O 指令 |
| 缓存问题 | 需标记不可缓存 | 天然绕过缓存 |
| 硬件译码 | 较复杂(需区分区域) | 较简单(M/IO 信号区分) |
| 典型架构 | ARM、MIPS、RISC-V、PowerPC | x86(经典)、早期微机 |
| 保护/调试 | 较难从指令区分 | 容易区分 |
统一编址:端口 = 内存单元,共用地址空间,用 MOV 访问,指令简单但占内存空间、需防缓存。
独立编址:端口 = 独立地址空间,用 IN/OUT 访问,指令分明、不占内存,但需专门指令、寻址受限。
两者本质区别在于:端口与内存是否共享同一个地址空间,以及由此决定的访问指令不同。
IO控制方式
CPU和外设之间交换数据有四种控制方式。程序查询,程序中断,dma,通道。
- 程序查询方式:cpu不停的读状态端口,询问设备有没有准备好。准备好了才传一个数据。CPU和外设完全串行工作,大量时间都浪费在等待上。
- 程序中断:CPU启动外设后就去执行自己的程序,外设准备好后,主动发送中断请求,CPU暂停当前程序,去执行中断程序传送数据。完成后再返回。这样CPU和外设就能同时工作了。
CPU响应中断的条件:有中断请求,开中断,一条指令执行完毕。多个中断同时请求时,要进行中断判优。一般顺序是,硬件故障最高,然后是软件中断,再是非屏蔽中断,可屏蔽中断。
- 硬件故障,是硬件本身出现严重问题引发的中断,比如内存奇偶校验,电源故障,总线错误,CPU必须立即处理否则系统会崩溃。
- 软件中断:由CPU执行特定的指令,比如陷入,systemcall,人为触发的中断,通常称为陷入
- 非屏蔽中断:特殊的硬件中断,CPU不能通过软件来屏蔽。比如时钟中断、掉电警告等。
- 可屏蔽中断:相对较低优先级,比如键盘鼠标磁盘等发出的中断请求。CPU可以通过设置中断屏蔽字来暂时不响应这些中断。
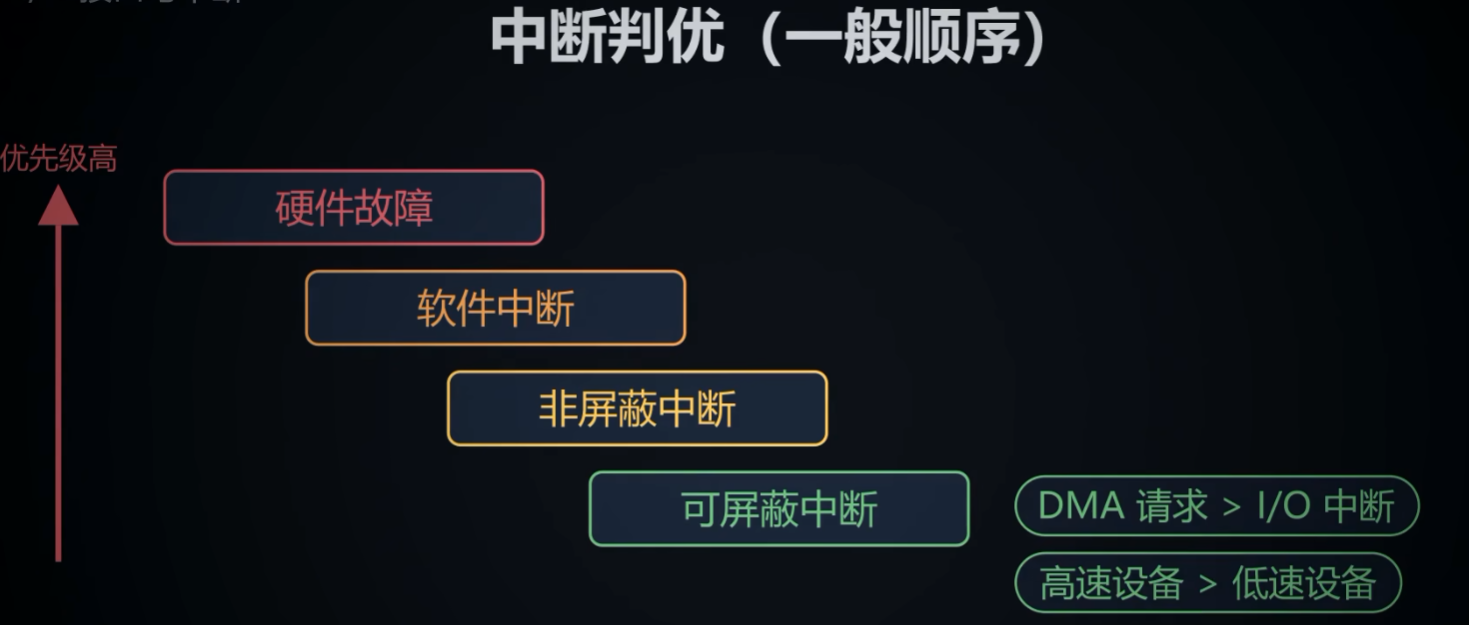
响应中断后,硬件会自动执行一条中断隐指令。它不是真正的指令,而是硬件完成的三件事。关中断,保存断点,引出中断服务程序(把服务程序的入口地址送入pc)。然后才轮到中断程序本身,保护线程,把寄存器内容压栈;执行中断服务。比如传送数据恢复现场。最后开中断,中断返回。
这里保存断点、关中断是硬件做的。保护现场恢复线程是中断服务程序做的。
中断屏蔽字可以用来改变中断程序优先级。中断屏蔽字不能改变硬件电路上物理连接的绝对优先级(比如不能把键盘的优先级弄得比网卡物理线路上还高),但它能改变 CPU 当前实际响应中断的顺序。通过写屏蔽字,你可以让 CPU 暂时“听不见”某些低优先级中断,从而在逻辑上动态提升当前正在处理的中断的优先级。
处理优先级越高,屏蔽字中1越多,每个中断源一定屏蔽自己。
中断嵌套是CPU在处理一个中断服务程序(ISR)的过程中,如果又有一个优先级更高的中断请求到来,CPU会暂停当前正在执行的中断服务程序,转去处理那个更高优先级的中断;等更高优先级的中断处理完成后,再返回来继续执行原来被暂停的中断服务程序。中断嵌套是靠中断屏蔽关键字来实现的。
CPU 进入中断服务程序后,如果不做任何屏蔽,那么任何其他中断都可能打断它,这会导致低级中断被频繁打断,甚至引发堆栈溢出或死锁。设置屏蔽字实现嵌套:当 CPU 响应并进入某级中断(假设为优先级 N)时,硬件或软件会修改中断屏蔽字,屏蔽掉当前级别及更低级别(≤ N)的中断,但不屏蔽更高级别(> N)的中断。
这就意味着:低优先级的中断无法打断当前处理,而高优先级的中断可以“长驱直入”打断当前处理。这就形成了嵌套。
默认情况下中断是不嵌套的。在绝大多数的经典 CPU 架构(如 x86 架构中的实模式)中,当 CPU 响应一个硬件可屏蔽中断并跳转到中断服务程序(ISR)时,硬件会自动执行一个动作:清除标志寄存器中的中断允许标志位(IF = 0),这相当于关闭了中断(常称为“关中断”)。
后果:当 CPU 正在执行当前的中断服务程序时,所有后续的硬件可屏蔽中断(无论优先级多高)都会被直接忽略或挂起,直到当前中断服务程序执行完毕并返回。
这就意味着,默认状态下是不发生可屏蔽中断嵌套的。 只有等当前中断处理完,执行 IRET 指令返回时,硬件才会自动恢复 IF 标志位(重新开中断),此时 CPU 才会去响应已经挂起的新中断。
这里要区分响应优先级和处理优先级。响应优先级是硬件排队电路决定,固定不变。处理优先级可通过屏蔽字改变。
响应优先级是硬件决定的入场顺序,处理优先级是软件可调的嵌套规则。
DMA与外部设备
中断方式虽然让CPU和外部设备并行,但是每传送一个字都要中断一次。执行一段服务程序。对磁盘这种高速成块传送的设备,CPU会被频繁打断忙不过来。
于是又了DMA:直接存储器存取。在主存和外设之间开辟一条直接的数据通路。由DMA控制器来接管总线来传输数据。整个数据传送期间CPU都不需要参与。
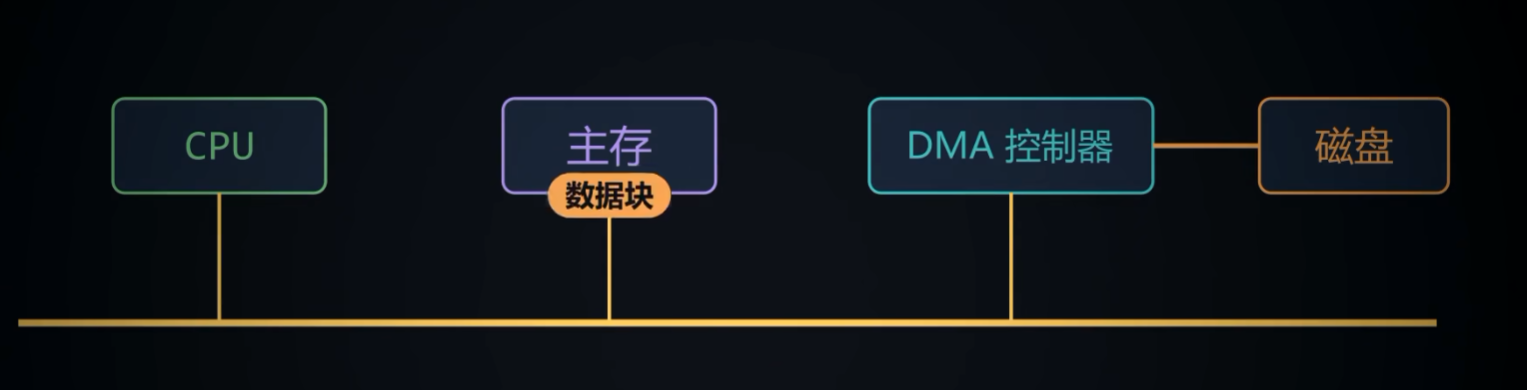
DMA控制器中有
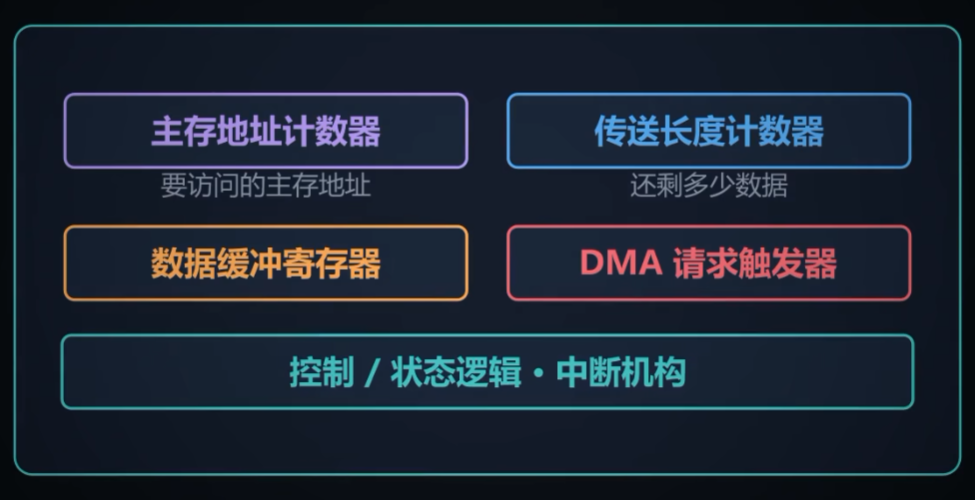
DMA传送分为三个阶段,
- 预处理:CPU执行几条指令,告诉DMA控制器其实地址,传送字数和方向。然后启动设备。
- 数据传送,完全由DMA控制器硬件完成;传送结束后,DMA控制器向CPU发送一个中段请求。
- 后处理:数据传送完成后,DMA 控制器向 CPU 发出中断请求。CPU 执行中断服务程序,校验数据是否正确,并决定是否继续下一次 DMA 传输。
DMA和CPU都要访问主存,冲突了怎么办?有三种方式
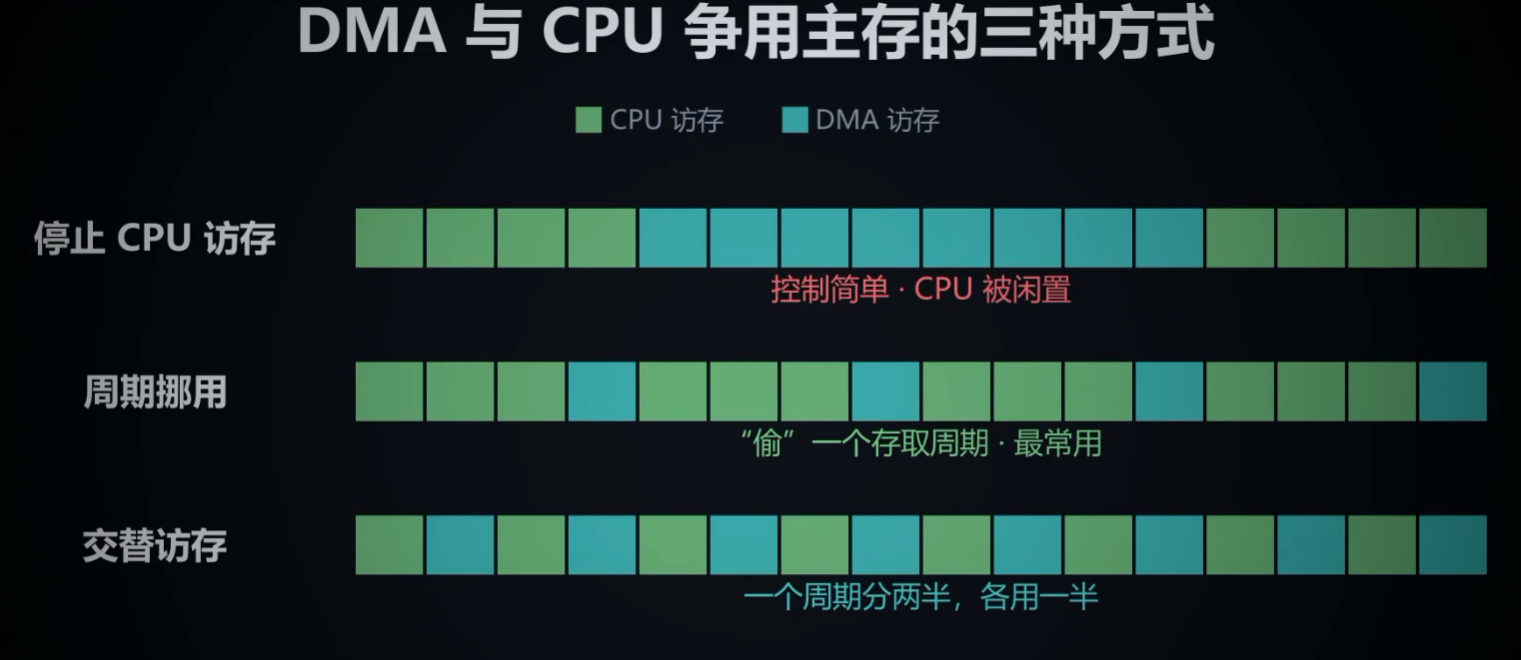
其中周期挪用用的最多。DMA和CPU设备同时访存时,DMA优先(因为IO设备的数据不及时取走会丢失)
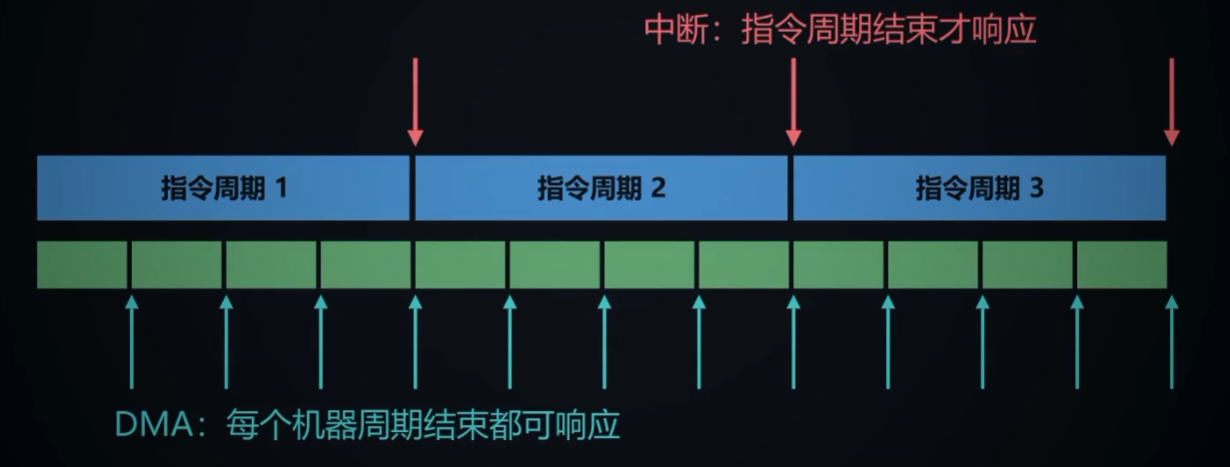
另外,CPU在每个机器周期结束后都可以响应DMA请求。而中断请求,只在指令周期结束时才响应。
| 程序中断 | DMA | |
|---|---|---|
| 传送方式 | 程序切换(保护 / 恢复现场) | 硬件直接传送 |
| 每次传送 | 一个字 | 一个数据块 |
| 适用 | 低速设备 · 异常处理 | 高速设备 · 只传数据 |
| 响应时机 | 指令周期结束 | 机器周期结束 |
| 优先级 | 低 | 高 |